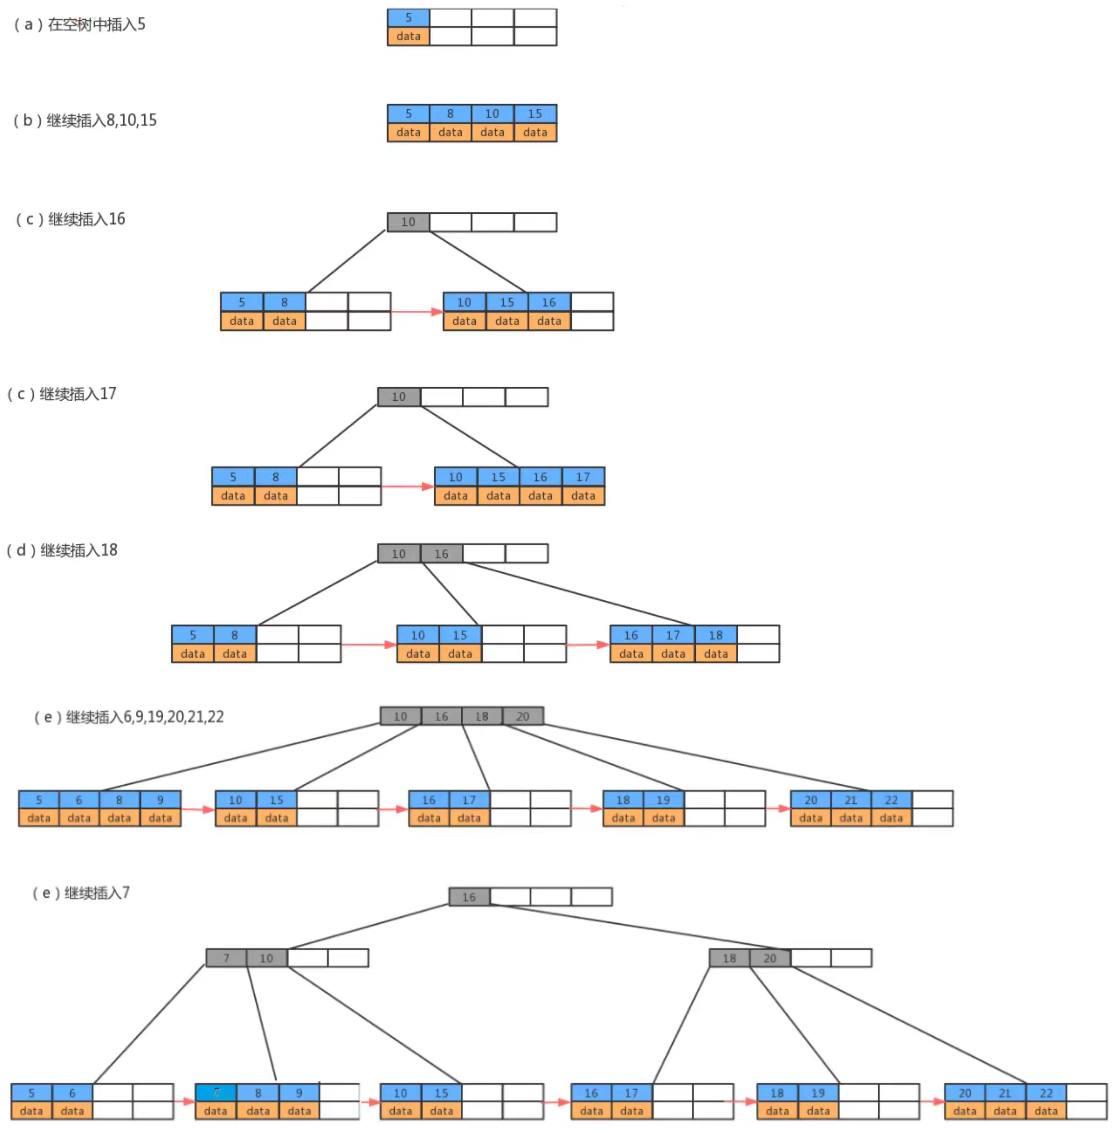
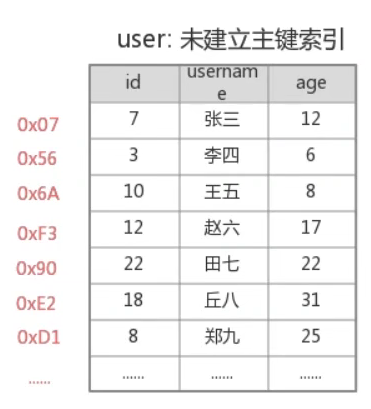
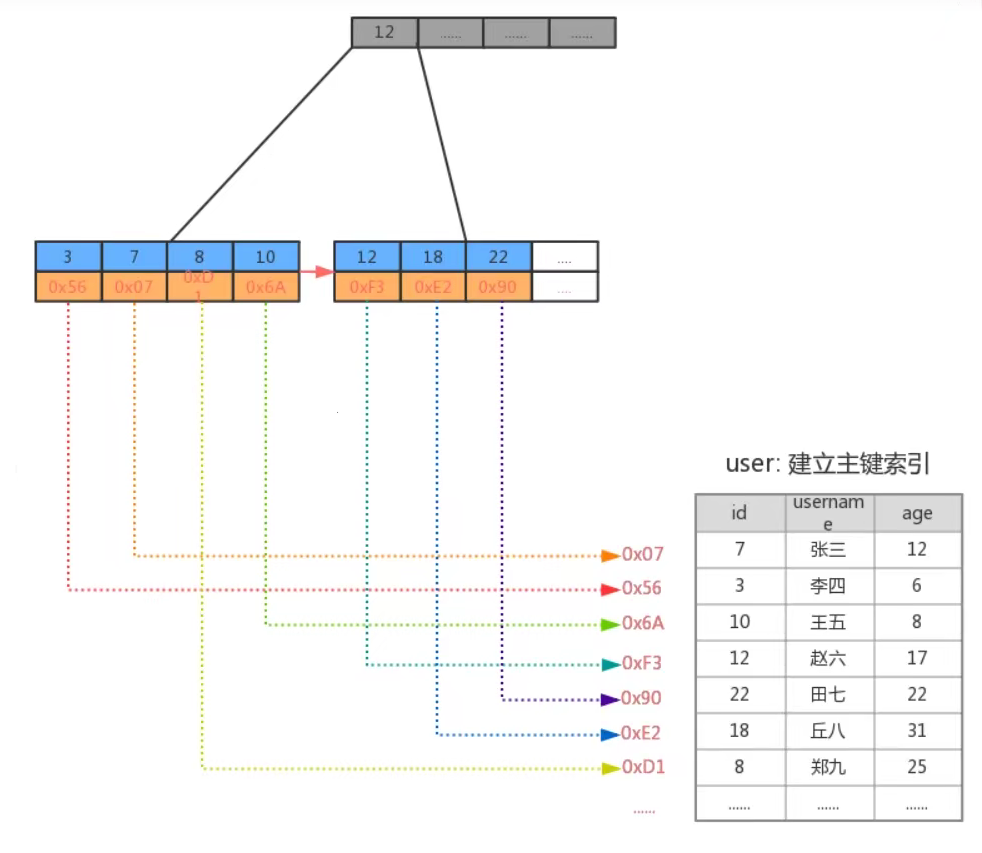
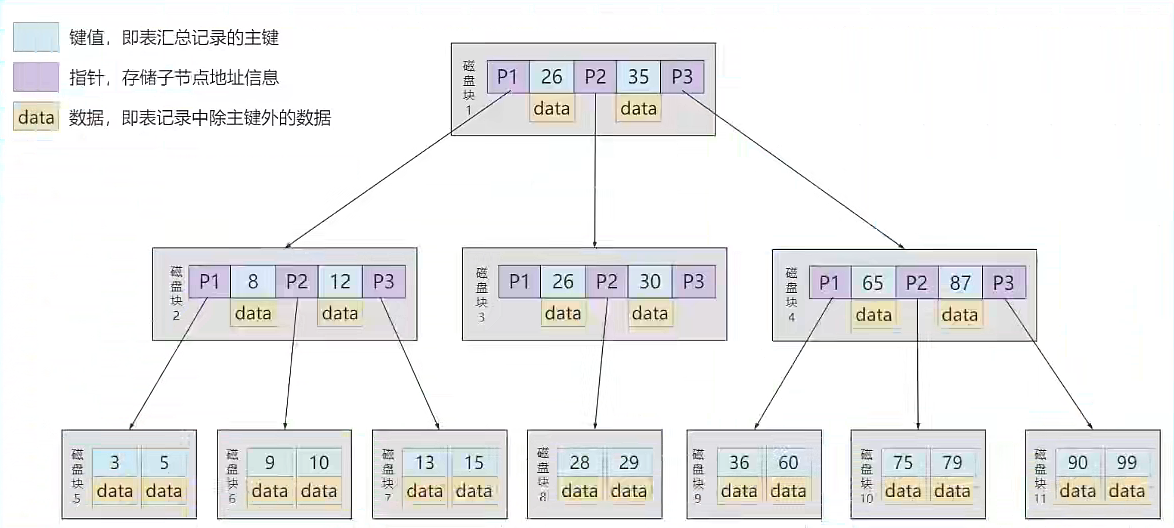
算法与数据结构 概述 数据结构和算法的重要性
算法是程序的灵魂 ,优秀的程序可以在海量数据计算时,依然保持高速计算一般来讲 程序会使用了内存计算框架(比如Spark)和缓存技术(比如Redis等)来优化程序,再深入的思考一下,这些计算框架和缓存技术,它的核 心功能是哪个部分呢?
拿实际工作经历来说, 在Unix下开发服务器程序,功能是要支持上千万人同时在线,在上线前,做内测,一切OK,可上线后,服务器就支撑不住了,公司的CTO对代码进行优化,再次上线,坚如磐石。你就能感受到程序是有灵魂的,就是算法。
目前程序员面试的门槛越来越高,很多一线IT公司 (大厂),都会有数据结构和算法面试题 (负责的告诉你,肯定有的)
如果你不想永远都是代码工人,那就花时间来研究下数据结构和算法
数据结构和算法的关系
数据data结构(structure)是一门研究组织数据方式 的学科,有了编程语言也就有了数据结构学好数据结构可以编写出更加漂亮,更加有效率的代码。
要学习好数据结构就要多多考虑如何将生活中遇到的问题,用程序去实现解决.
程序=数据结构+算法 数据结构是算法的基础 ,换言之,想要学好算法,需要把数据结构学到位。
线性结构
线性结构作为最常用的数据结构,其特点是数据元素之间存在一对一 的线性关系。
线性结构有两种不同的存储结构,即**顺序存储结构(数组)和 链式存储结构(链表)**。
顺序存储的线性表称为顺序表,顺序表中的存储元素是连续 的。
链式存储的线性表称为链表,链表中的存储元素不一定是连续的 ,元素节点中存放数据元素以及相邻元素的地址信息。
线性结构常见的有:数组、队列、链表和栈
非线性结构 非线性结构包括:二维数组,多维数组,广义表,树结构 ,图结构
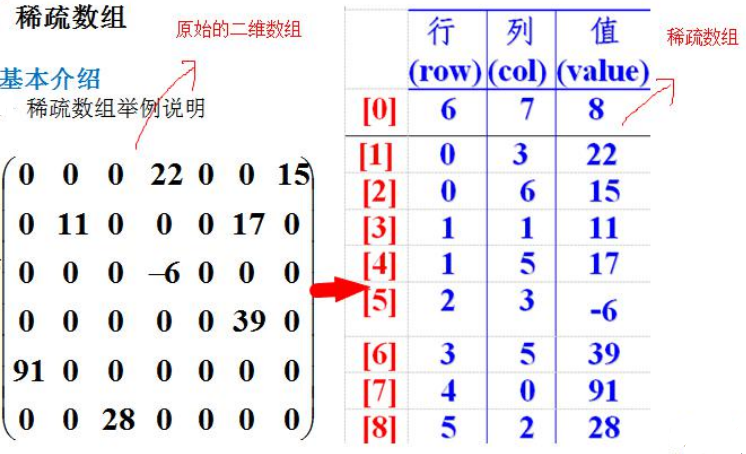
稀疏数组和队列 稀疏矩阵 概述 当一个数组中大部分元素为0,或者为同一个值的数组时,可以使用稀疏数组来保存该数组。
稀疏数组的处理方法是:
记录数组一共有几行几列,有多少个不同的值 把具有不同值的元素的行列及值记录在一个小规模的数组中。从而缩小程序的规模
实例
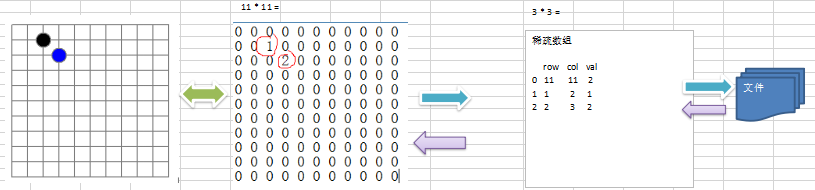
使用稀疏数组,用于保留二维数组(棋盘、地图……)
把稀疏数组存盘,并且可以重新恢复原来的二维数组
思路分析
二维数组转稀疏数组
遍历原始的二维数组,得到有效数据的个数sum
根据sum就可以建立稀疏数组sparseArr int [sum+1] [3]
将二维数组的有效数据存入到稀疏数组
稀疏数组转二维数组
先读取稀疏数组的第一行,根据第一行的数据,创建原始的二维数组,比如上面的 chessArr2 = int [11] [11]
在读取稀疏数组后几行的数据,并赋给 原始的二维数组即可.
代码实现 public class SparseArray { public static void main (String[] args) throws IOException { String fileName = "E:\\Program\\AlgorithmStudy\\src\\com\\algorithm\\_1_1sparsearray\\sparseArray.txt" ; int chessArr1[][] = new int [11 ][11 ]; chessArr1[1 ][2 ] = 1 ; chessArr1[2 ][3 ] = 2 ; System.out.println("原始的二维数组:" ); for (int [] arr : chessArr1) { for (int data : arr) { System.out.printf("%d\t" , data); } System.out.println(); } System.out.println(); int sum = 0 ; for (int i = 0 ; i < chessArr1.length; i++) { for (int j = 0 ; j < chessArr1[i].length; j++) { if (chessArr1[i][j] != 0 ) { sum++; } } } System.out.println("稀疏数组中非零元素的个数:" + sum); int sparseArr[][] = new int [sum + 1 ][3 ]; sparseArr[0 ][0 ] = 11 ; sparseArr[0 ][1 ] = 11 ; sparseArr[0 ][2 ] = sum; int count = 0 ; for (int i = 0 ; i < 11 ; i++) { for (int j = 0 ; j < 11 ; j++) { if (chessArr1[i][j] != 0 ) { count++; sparseArr[count][0 ] = i; sparseArr[count][1 ] = j; sparseArr[count][2 ] = chessArr1[i][j]; } } } System.out.println(); System.out.println("得到的稀疏数组:" ); for (int i = 0 ; i < sparseArr.length; i++) { for (int j = 0 ; j < 3 ; j++) { System.out.printf("%d\t" , sparseArr[i][j]); } System.out.println(); } System.out.println(); System.out.println("保存稀疏数组到本地" ); SaveToLocal(fileName, sparseArr); System.out.println(); System.out.println("正在读取本地稀疏数组文件" ); int [][] readArray = ReadByLocal(fileName); printArray(readArray); System.out.println(); System.out.println("读取到的稀疏数组:" ); for (int i = 0 ; i < readArray.length; i++) { for (int j = 0 ; j < 3 ; j++) { System.out.printf("%d\t" , readArray[i][j]); } System.out.println(); } System.out.println(); int chessArr2[][] = new int [readArray[0 ][0 ]][readArray[0 ][1 ]]; for (int i = 1 ; i < sparseArr.length; i++) { chessArr2[readArray[i][0 ]][readArray[i][1 ]] = readArray[i][2 ]; } for (int [] arr : chessArr2) { for (int data : arr) { System.out.printf("%d\t" , data); } System.out.println(); } } private static void SaveToLocal (String fileName, int [][] sparseArray) throws IOException { BufferedWriter bw = new BufferedWriter (new FileWriter (new File (fileName), false )); StringBuffer sb = new StringBuffer (); for (int [] row : sparseArray) { for (int i : row) { sb.append(i + "\t" ); } sb.append("\r\n" ); } bw.write(sb.toString()); bw.flush(); bw.close(); } private static int [][] ReadByLocal(String fileName) throws IOException { int row = 0 , col = 0 ; List<int []> readList = new ArrayList <>(); BufferedReader bufferedReader = new BufferedReader (new InputStreamReader (new FileInputStream (new File (fileName)))); String line = null ; while ((line = bufferedReader.readLine()) != null ) { int [] array = Arrays.stream(line.split("\\t" )).mapToInt(Integer::parseInt).toArray(); System.out.println("读取到的稀疏数组:" + Arrays.toString(array)); readList.add(array); col = array.length; } row = readList.size(); bufferedReader.close(); int [][] readArray = new int [row][col]; for (int i = 0 ; i < readArray.length; i++) { readArray[i] = readList.get(i); } return readArray; } }
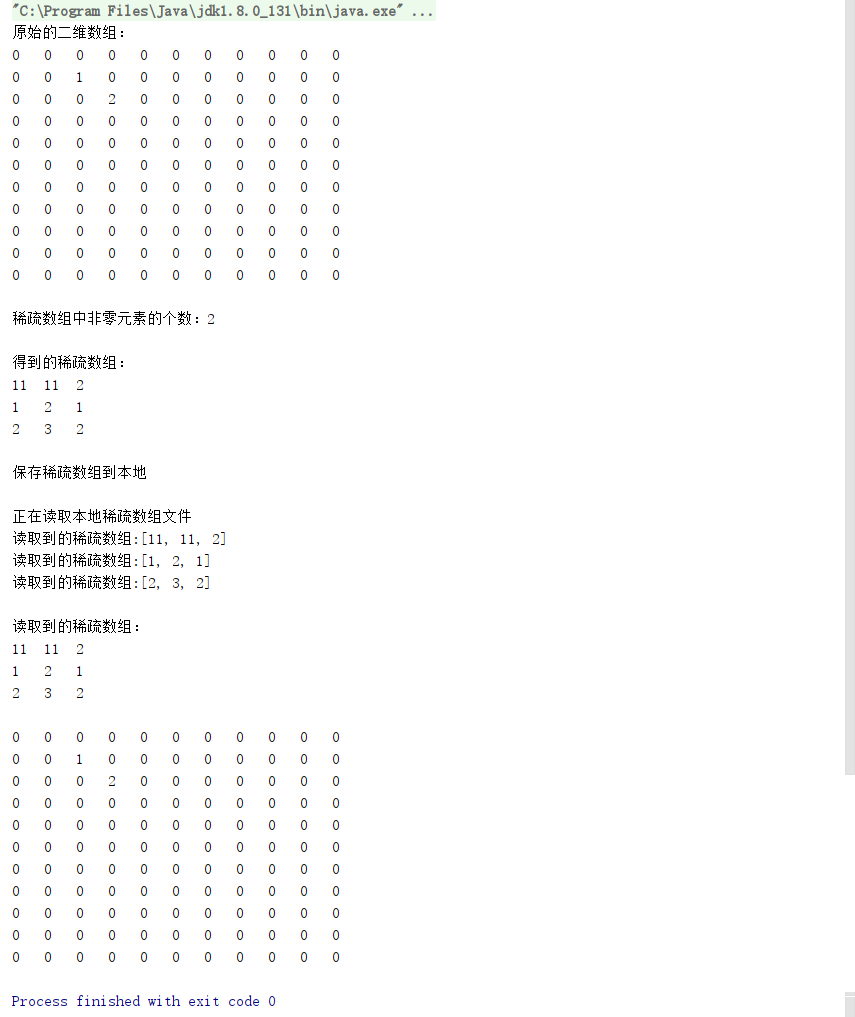
运行结果
队列 概述
队列是一个有序列表 ,可以用数组 或是链表 来实现。
遵循先入先出 的原则。即:先存入队列的数据,要先取出 。后存入的要后取出
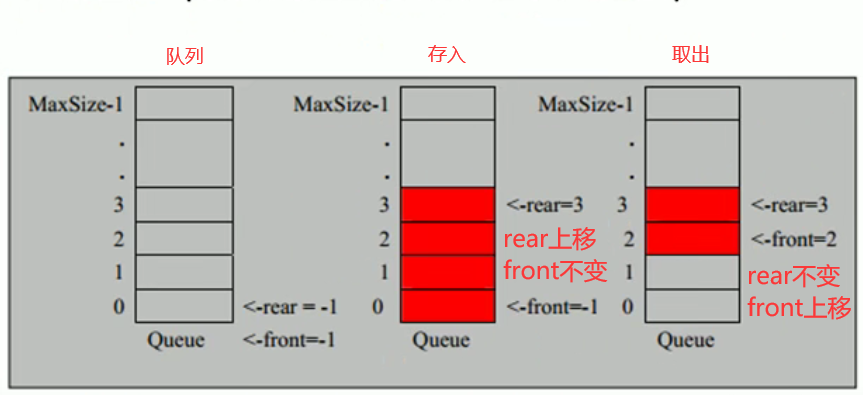
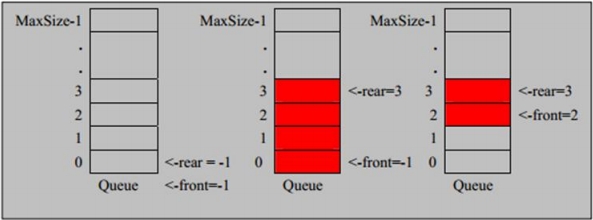
示意图: (使用数组模拟队列示意图)
rear表示队尾
front表示队首
存入时从队尾加入数据,取出时从队首取出数据
实例1 利用数组模拟队列
思路分析 队列本身是有序列表,若使用数组的结构来存储队列的数据,则队列数组的声明如下图,其中maxSize是该队列的最大容量 。
因为队列的输出、输入是分别从前后端来处理,因此需要两个变量front及rear分别记录队列前后端的下标 ,front会随着数据输出而改变 ,而rear则是随着数据输入而改变 ,如图所示:
当我们将数据存入队列时称为”addQueue”,addQueue的处理需要有两个步骤:
将尾指针往后移:rear+1,当front==rear[空]
若尾指针rear小于队列的最大下标maxSize-1, 则将数据存入rear所指的数组元素中,否则无法存入数据。(**rear==maxSize-1[队列满]**)
代码实现 public class ArrayQueueDemo { public static void main (String[] args) { ArrayQueue queue = new ArrayQueue (3 ); char key = ' ' ; Scanner scanner = new Scanner (System.in); boolean loop = true ; while (loop){ System.out.println("show(s):显示队列" ); System.out.println("exit(e):退出程序" ); System.out.println("add(a):添加数据到队列" ); System.out.println("get(g):从队列取出数据" ); System.out.println("head(h):查看队列头的数据" ); key = scanner.next().charAt(0 ); switch (key){ case 's' : queue.showQueue(); break ; case 'a' : System.out.println("输入一个数据" ); int value = scanner.nextInt(); queue.addQueue(value); break ; case 'g' : try { int res = queue.getQueue(); System.out.println("取出数据是" +res); }catch (Exception e){ System.out.println(e.getMessage()); } break ; case 'h' : try { int res = queue.headQueue(); System.out.println("队列头的数据是" +res); }catch (Exception e){ System.out.println(e.getMessage()); } break ; case 'e' : scanner.close(); loop = false ; break ; default : break ; } } System.out.println("程序退出" ); } } class ArrayQueue { private int maxSize; private int front; private int rear; private int [] arr; public ArrayQueue (int arrMaxSize) { maxSize = arrMaxSize; arr = new int [maxSize]; front = -1 ; rear = -1 ; } public boolean isFull () { return rear == maxSize - 1 ; } public boolean isEmpty () { return rear == front; } public void addQueue (int n) { if (isFull()) { System.out.println("队列满,不能加入数据" ); return ; } rear++; arr[rear] = n; System.out.println("添加成功" ); } public int getQueue () { if (isEmpty()) { throw new RuntimeException ("队列空,不能取数据" ); } front++; System.out.println("已取出" ); return arr[front]; } public void showQueue () { if (isEmpty()){ System.out.println("队列空,没有数据" ); return ; } for (int i = 0 ;i < arr.length;i++){ System.out.println("队列元素为:" ); System.out.println("arr[" +i+"]=" +arr[i]); } } public int headQueue () { if (isEmpty()){ throw new RuntimeException ("队列空,没有数据" ); } return arr[front+1 ]; } }
存在问题
目前的队列使用一次就不能能再使用了
解决方案:将此队列改进为环形队列
实例2 对前面的数组模拟队列的优化,充分利用数组.。因此将数组看做是一个环形的。(通过取模的方式来实现即可)
思路分析
尾索引的下一个为头索引时表示队列满,即将队列容量空出一个作为约定,这个在做判断队列满的时候需要注意(rear+1)%maxSize==front[满]
rear=front[空]
思路调整
front 变量的含义做一个调整:front 就指向队列的第一个元素,也就是说 arr[front] 就是队列的第一个元素 front 的初始值 = 0
rear变量的含义做一个调整:rear 指向队列的最后一个元素的后一个位置。因为希望空出一个空间做为约定。rear 的初始值 = 0
队列满时的条件:(rear+1)% maxSize==front 【满】
队列为空的条件: rear == front 【空】
当我们这样分析, 队列中有效的数据的个数 ==(rear + maxSize - front) % maxSize==
我们就可以在原来的队列上修改得到,一个环形队列
代码实现 public class CircleArrayQueueDemo { public static void main (String[] args) { System.out.println("测试数组模拟环形队列的案例~~~" ); CircleArray queue = new CircleArray (4 ); char key = ' ' ; Scanner scanner = new Scanner (System.in); boolean loop = true ; while (loop) { System.out.println("s(show):显示队列" ); System.out.println("e(exit):退出程序" ); System.out.println("a(add):添加数据到队列" ); System.out.println("g(get):从队列取出数据" ); System.out.println("h(head):查看队列头的数据" ); key = scanner.next().charAt(0 ); switch (key) { case 's' : queue.showQueue(); break ; case 'a' : System.out.println("输入一个数据" ); int value = scanner.nextInt(); queue.addQueue(value); break ; case 'g' : try { int res = queue.getQueue(); System.out.println("取出数据是" + res); } catch (Exception e) { System.out.println(e.getMessage()); } break ; case 'h' : try { int res = queue.headQueue(); System.out.println("队列头的数据是" + res); } catch (Exception e) { System.out.println(e.getMessage()); } break ; case 'e' : scanner.close(); loop = false ; break ; default : break ; } } System.out.println("程序退出" ); } } class CircleArray { private int maxSize; private int front; private int rear; private int [] arr; public CircleArray (int arrMaxSize) { maxSize = arrMaxSize; arr = new int [maxSize]; } public boolean isFull () { return (rear + 1 ) % maxSize == front; } public boolean isEmpty () { return rear == front; } public void addQueue (int n) { if (isFull()) { System.out.println("队列满,不能加入数据" ); return ; } arr[rear] = n; rear = (rear + 1 ) % maxSize; } public int getQueue () { if (isEmpty()) { throw new RuntimeException ("队列空,不能取数据" ); } int value = arr[front]; front = (front + 1 ) % maxSize; return value; } public void showQueue () { if (isEmpty()) { System.out.println("队列空,没有数据" ); return ; } for (int i = front; i < front + size(); i++) { System.out.println("arr[" + (i % maxSize) + "]=" + arr[i % maxSize]); } } public int size () { return (rear + maxSize - front) % maxSize; } public int headQueue () { if (isEmpty()) { throw new RuntimeException ("队列空,没有数据" ); } return arr[front]; } }
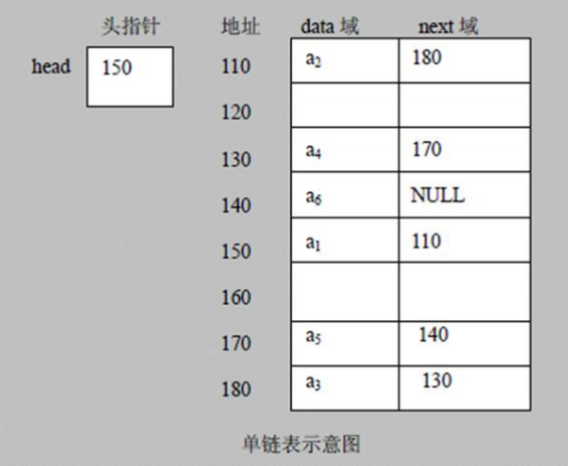
链表 概述 链表是有序的列表,但是它在内存中是存储如下
小结上图:
链表是以节点的方式来存储,是链式存储 。
每个节点包含 data 域, next 域:指向下一个节点。
如图:发现链表的各个节点不一定是连续存储 。
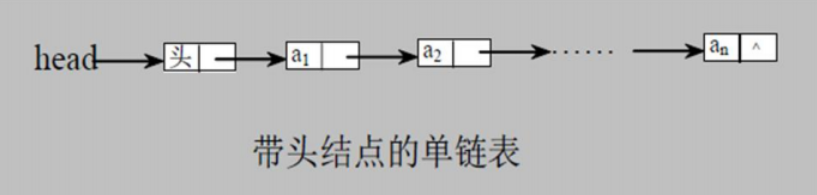
链表分带头节点的链表 和没有头节点的链表 ,根据实际的需求来确定。
单向链表 使用带 head 头的单向链表实现——水浒英雄排行榜管理完成对英雄人物的增删改查操作, 注: 删除和修改
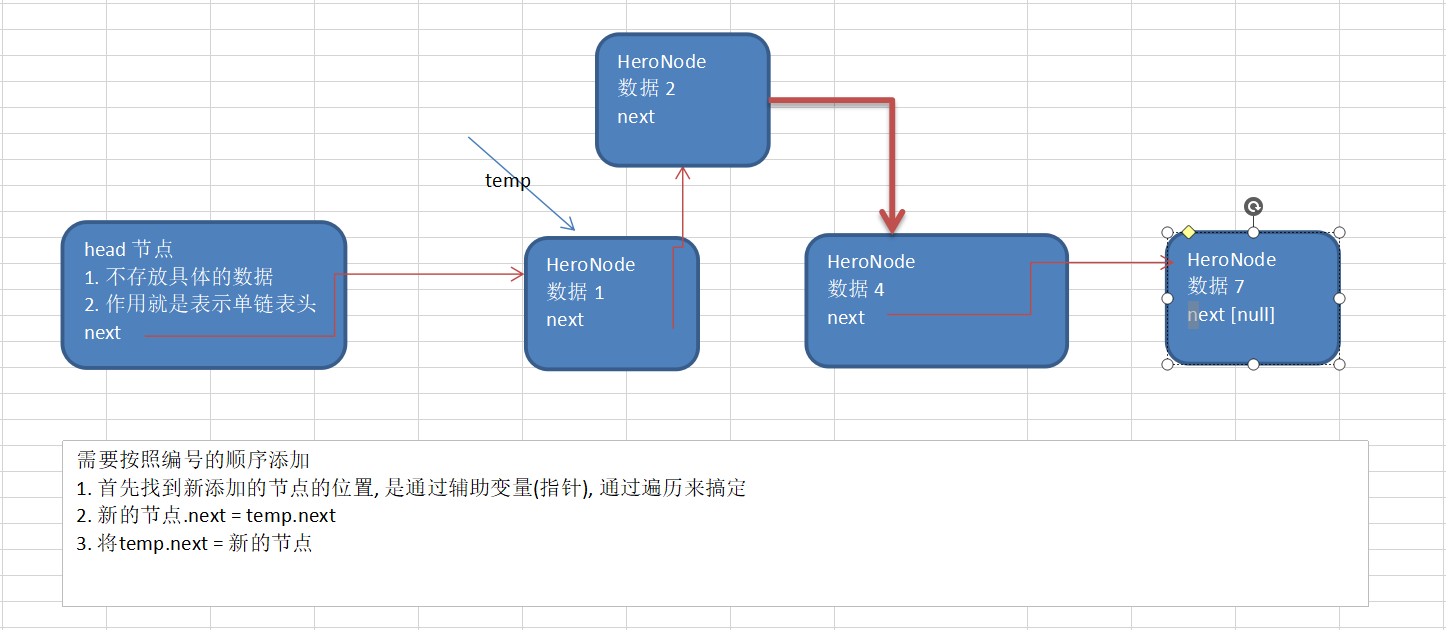
实例1 思路分析 1、第一种方法在添加英雄时,直接添加到链表的尾部 思路分析示意图:
public void add (HeroNode heroNode) { HeroNode temp = head; while (true ) { if (temp.next == null ) { break ; } temp = temp.next; } temp.next = heroNode; }
2、第二种方式在添加英雄时,根据排名 将英雄插入到指定位置(如果有这个排名,则添加失败,并给出提示) 思路的分析示意图:
public void addByOrder (HeroNode heroNode) { HeroNode temp = head; boolean flag = false ; while (true ) { if (temp.next == null ) { break ; } if (temp.next.no > heroNode.no) { break ; } else if (temp.next.no == heroNode.no) { flag = true ; break ; } temp = temp.next; } if (flag) { System.out.println("准备插入的英雄的编号" +heroNode.no+"已经存在了,不能加入" ); } else { heroNode.next = temp.next; temp.next = heroNode; } }
3、修改节点功能
思路:
先找到该节点,通过遍历
```
```java
//修改节点的信息,根据no编号来修改,即no编号不能改
//说明
//1.根据newHeroNode的no来修改即可
public void update(HeroNode newHeroNode) {
    //判断是否为空
    if (head.next == null) {//链表的有效节点并不包括头指针,头指针通常用head定义,他只是指向第一个有效结点;无论链表是否为空,头指针都不为空;头指针并不存放有效数据!
        System.out.println("链表为空");
        return;
    }
    //找到需要修改的节点,根据no编号
    //先定义一个辅助变量
    HeroNode temp = head.next;
    boolean flag = false;//表示是否找到节点
    while (true) {
        if (temp == null) {
            break;//已经遍历完链表
        }
        if (temp.no == newHeroNode.no) {
            //找到
            flag = true;
            break;
        }
        temp = temp.next;
    }
    //根据flag是否找到要修改的节点
    if (flag) {
        temp.name = newHeroNode.name;
        temp.nickname = newHeroNode.nickname;
    } else {
        System.out.printf("没有找到编号%d的节点,不能修改\n", newHeroNode.no);
    }
}
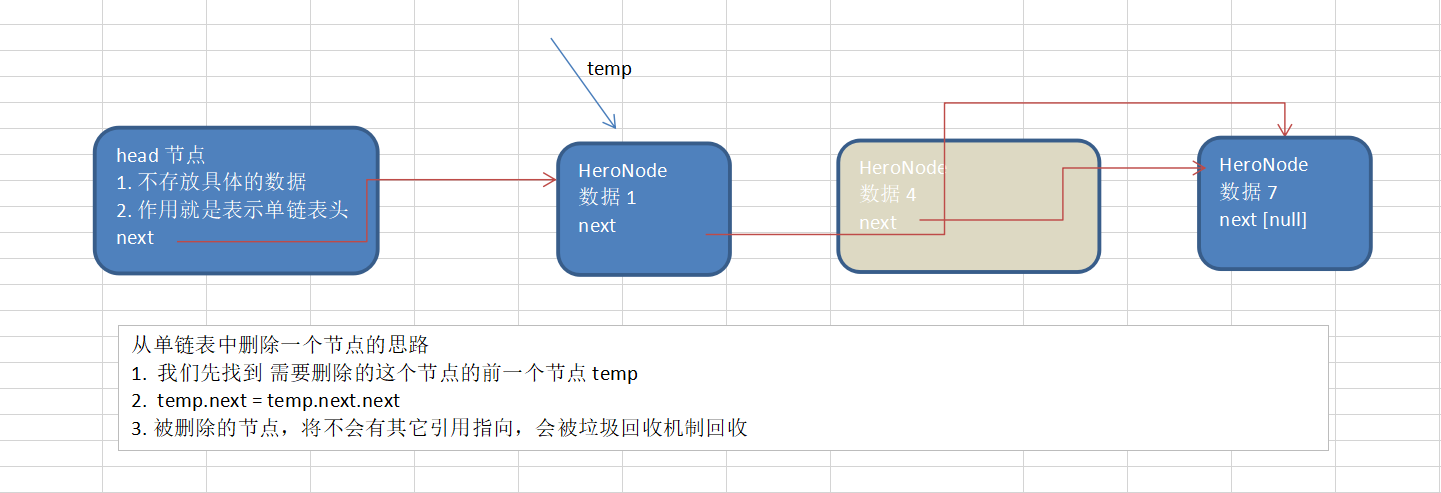
4、删除节点
思路分析的示意图:
public void del (int no) { HeroNode temp = head; boolean flag = false ; while (true ) { if (temp.next == null ) { break ; } if (temp.next.no == no) { flag = true ; break ; } temp = temp.next; } if (flag) { temp.next = temp.next.next; } else { System.out.printf("要删除的%d 节点不存在\n" , no); } }
代码实现 public class SingleLinkedListDemo { public static void main (String[] args) { HeroNode hero1 = new HeroNode (1 , "宋江" , "及时雨" ); HeroNode hero2 = new HeroNode (2 , "卢俊义" , "玉麒麟" ); HeroNode hero3 = new HeroNode (3 , "吴用" , "智多星" ); HeroNode hero4 = new HeroNode (4 , "林冲" , "豹子头" ); SingleLinkedList singleLinkedList = new SingleLinkedList (); singleLinkedList.addByOrder(hero1); singleLinkedList.addByOrder(hero4); singleLinkedList.addByOrder(hero2); singleLinkedList.addByOrder(hero3); singleLinkedList.list(); HeroNode newHeroNode = new HeroNode (4 , "冲冲" , "豹豹头" ); singleLinkedList.update(newHeroNode); System.out.println("修改后的链表情况:" ); singleLinkedList.list(); singleLinkedList.del(1 ); singleLinkedList.del(4 ); singleLinkedList.del(2 ); singleLinkedList.del(3 ); System.out.println("删除后的链表情况:" ); singleLinkedList.list(); } } class SingleLinkedList { private HeroNode head = new HeroNode (0 , "" , "" ); public void add (HeroNode heroNode) { HeroNode temp = head; while (true ) { if (temp.next == null ) { break ; } temp = temp.next; } temp.next = heroNode; } public void addByOrder (HeroNode heroNode) { HeroNode temp = head; boolean flag = false ; while (true ) { if (temp.next == null ) { break ; } if (temp.next.no > heroNode.no) { break ; } else if (temp.next.no == heroNode.no) { flag = true ; break ; } temp = temp.next; } if (flag) { System.out.println("准备插入的英雄的编号" +heroNode.no+"已经存在了,不能加入" ); } else { heroNode.next = temp.next; temp.next = heroNode; } } public void update (HeroNode newHeroNode) { if (head.next == null ) { System.out.println("链表为空" ); return ; } HeroNode temp = head.next; boolean flag = false ; while (true ) { if (temp == null ) { break ; } if (temp.no == newHeroNode.no) { flag = true ; break ; } temp = temp.next; } if (flag) { temp.name = newHeroNode.name; temp.nickname = newHeroNode.nickname; } else { System.out.printf("没有找到编号%d的节点,不能修改\n" , newHeroNode.no); } } public void del (int no) { HeroNode temp = head; boolean flag = false ; while (true ) { if (temp.next == null ) { break ; } if (temp.next.no == no) { flag = true ; break ; } temp = temp.next; } if (flag) { temp.next = temp.next.next; } else { System.out.printf("要删除的%d 节点不存在\n" , no); } } public void list () { if (head.next == null ) { System.out.println("链表为空" ); return ; } HeroNode temp = head.next; while (true ) { if (temp == null ) { break ; } System.out.println(temp); temp = temp.next; } } } class HeroNode { public int no; public String name; public String nickname; public HeroNode next; public HeroNode (int no, String name, String nickname) { this .no = no; this .name = name; this .nickname = nickname; } @Override public String toString () { return "HeroNode{" + "no=" + no + ", name='" + name + '\'' + ", nickname='" + nickname + '\'' + '}' ; } }
面试1 ==求单链表中有效节点的个数==
具体实现
public static int getLength (HeroNode head) { int length = 0 ; if (head.next==null ){ return 0 ; } HeroNode heroNode = head.next; while (heroNode!=null ){ length++; heroNode = heroNode.next; } return length; }
测试类
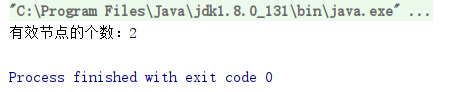
public static void main (String[] args) { SingleLinkedList singleLinkedList = new SingleLinkedList (); HeroNode hero1 = new HeroNode (1 , "宋江" , "及时雨" ); HeroNode hero2 = new HeroNode (2 , "卢俊义" , "玉麒麟" ); singleLinkedList.addByOrder(hero1); singleLinkedList.addByOrder(hero2); System.out.println("有效节点的个数:" +getLength(singleLinkedList.getHead())); }
运行结果
面试2 ==查找单链表中的倒数第 k 个结点==
具体实现
public static HeroNode findLastIndexNode (HeroNode head, int index) { int size = getLength(head); if (head.next == null ) { return null ; } if (index < 0 || index > size) { return null ; } HeroNode heroNode = head.next; for (int i = 0 ; i < size - index; i++) { heroNode = heroNode.next; } return heroNode; }
测试类
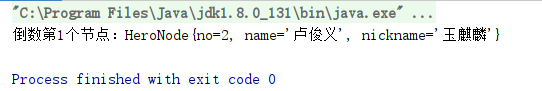
public static void main (String[] args) { SingleLinkedList singleLinkedList = new SingleLinkedList (); HeroNode hero1 = new HeroNode (1 , "宋江" , "及时雨" ); HeroNode hero2 = new HeroNode (2 , "卢俊义" , "玉麒麟" ); singleLinkedList.addByOrder(hero1); singleLinkedList.addByOrder(hero2); System.out.println("倒数第1个节点:" +findLastIndexNode(singleLinkedList.getHead(),1 ) ); }
运行结果
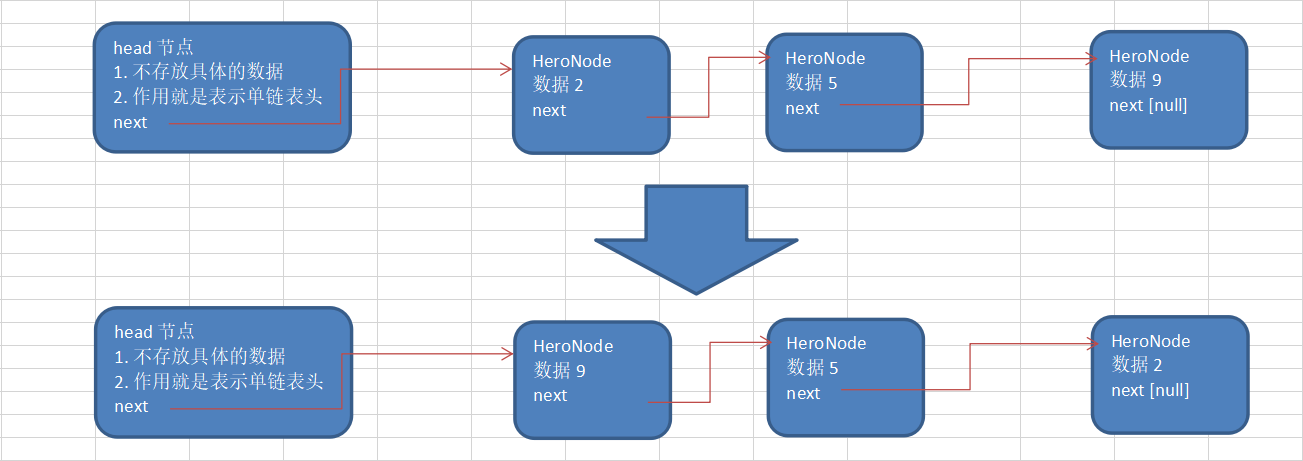
面试3 ==单链表的反转【腾讯面试题,有点难度】==
思路:
1、 先定义一个节点 reverseHead = new HeroNode();
2.、从头到尾遍历原来的链表,每遍历一个节点,就将其取出,并放在新的链表reverseHead 的最前端.
3、原来的链表的head.next = reverseHead.next
具体实现
public static void reversetList (HeroNode head) { if (head.next == null || head.next.next == null ) { return ; } HeroNode cur = head.next; HeroNode next = null ; HeroNode reverseHead = new HeroNode (0 , "" , "" ); while (cur != null ) { next = cur.next; cur.next = reverseHead.next; reverseHead.next = cur; cur = next; } head.next = reverseHead.next; }
测试类
public class Test {
    public static void main(String[] args) {

        SingleLinkedList singleLinkedList = new SingleLinkedList();

        HeroNode hero1 = new HeroNode(1, "宋江", "及时雨");
        HeroNode hero2 = new HeroNode(2, "卢俊义", "玉麒麟");
        HeroNode hero3 = new HeroNode(3, "吴用", "智多星");
        HeroNode hero4 = new HeroNode(4, "林冲", "豹子头");


        singleLinkedList.addByOrder(hero1);
        singleLinkedList.addByOrder(hero2);
        singleLinkedList.addByOrder(hero3);
        singleLinkedList.addByOrder(hero4);

        System.out.println("原本的链表");
        singleLinkedList.list();

        System.out.println("反转的链表");
        reversetList(singleLinkedList.getHead());
        singleLinkedList.list();

    }
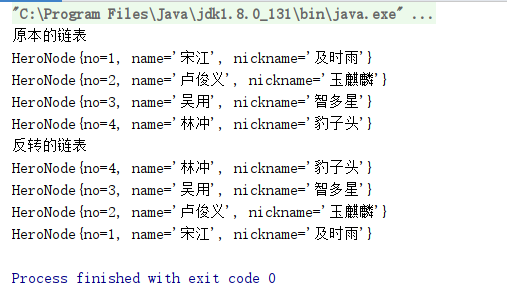
运行结果
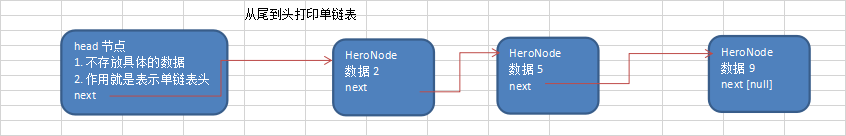
面试4 ==从尾到头打印单链表==
思路
1.、上面的题的要求就是逆序打印单链表.
2、方式1: 先将单链表进行反转操作,然后再遍历即可,这样的做的问题是会破坏原来的单链表的结构,不建议
3、**方式2:可以利用栈这个数据结构,将各个节点压入到栈中,然后利用栈的先进后出的特点,就实现了逆序打印的效果.
具体实现
public static void reversePrint (HeroNode head) { if (head.next == null ) { return ; } Stack<HeroNode> stack = new Stack <HeroNode>(); HeroNode cur = head.next; while (cur != null ) { stack.push(cur); cur = cur.next; } while (stack.size() > 0 ) { System.out.println(stack.pop()); } }
测试类
public class Test { public static void main (String[] args) { SingleLinkedList singleLinkedList = new SingleLinkedList (); HeroNode hero1 = new HeroNode (1 , "宋江" , "及时雨" ); HeroNode hero2 = new HeroNode (2 , "卢俊义" , "玉麒麟" ); HeroNode hero3 = new HeroNode (3 , "吴用" , "智多星" ); HeroNode hero4 = new HeroNode (4 , "林冲" , "豹子头" ); singleLinkedList.addByOrder(hero1); singleLinkedList.addByOrder(hero2); singleLinkedList.addByOrder(hero3); singleLinkedList.addByOrder(hero4); System.out.println("原本的链表" ); singleLinkedList.list(); System.out.println("反向输出" ); reversePrint(singleLinkedList.getHead()); }
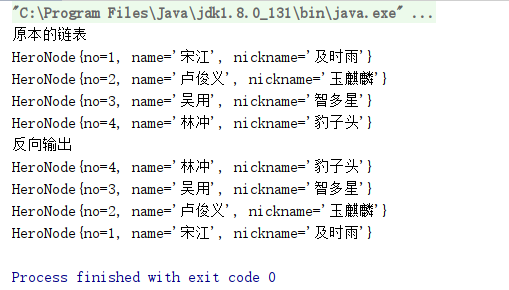
运行结果
面试5 合并两个有序的单链表,合并之后的链表依然有序
具体实现
public static HeroNode merge (HeroNode head1, HeroNode head2) { HeroNode reverseHead = new HeroNode (0 , "" , "" ); HeroNode cur = reverseHead; HeroNode l1 = head1.next; HeroNode l2 = head2.next; while (l1 != null && l2 != null ) { if (l2.no > l1.no) { cur.next = l1; l1 = l1.next; cur = cur.next; } if (l1.no > l2.no) { cur.next = l2; l2 = l2.next; cur = cur.next; } } if (l1 == null ) { cur.next = l2; } if (l2 == null ) { cur.next = l1; } return reverseHead.next; }
测试类
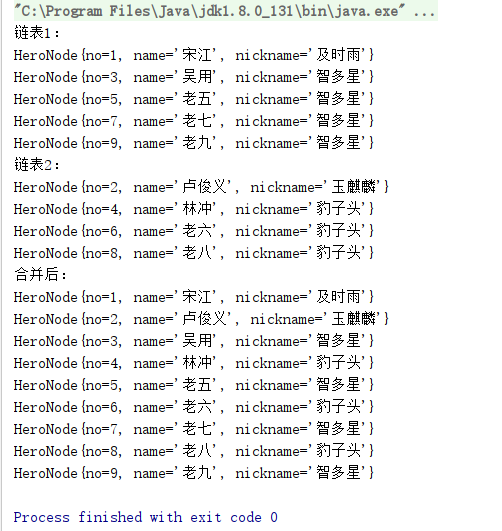
public class Test { public static void main (String[] args) { SingleLinkedList singleLinkedList1 = new SingleLinkedList (); SingleLinkedList singleLinkedList2 = new SingleLinkedList (); HeroNode hero1 = new HeroNode (1 , "宋江" , "及时雨" ); HeroNode hero2 = new HeroNode (2 , "卢俊义" , "玉麒麟" ); HeroNode hero3 = new HeroNode (3 , "吴用" , "智多星" ); HeroNode hero4 = new HeroNode (4 , "林冲" , "豹子头" ); HeroNode hero5 = new HeroNode (5 , "老五" , "智多星" ); HeroNode hero6 = new HeroNode (6 , "老六" , "豹子头" ); HeroNode hero7 = new HeroNode (7 , "老七" , "智多星" ); HeroNode hero8 = new HeroNode (8 , "老八" , "豹子头" ); HeroNode hero9 = new HeroNode (9 , "老九" , "智多星" ); singleLinkedList1.addByOrder(hero3); singleLinkedList1.addByOrder(hero1); singleLinkedList1.addByOrder(hero7); singleLinkedList1.addByOrder(hero5); singleLinkedList1.addByOrder(hero9); singleLinkedList2.addByOrder(hero2); singleLinkedList2.addByOrder(hero6); singleLinkedList2.addByOrder(hero8); singleLinkedList2.addByOrder(hero4); System.out.println("链表1:" ); singleLinkedList1.list(); System.out.println("链表2:" ); singleLinkedList2.list(); HeroNode merge = merge(singleLinkedList1.getHead(), singleLinkedList2.getHead()); System.out.println("合并后:" ); while (merge !=null ){ System.out.println(merge); merge = merge.next; } } }
运行结果
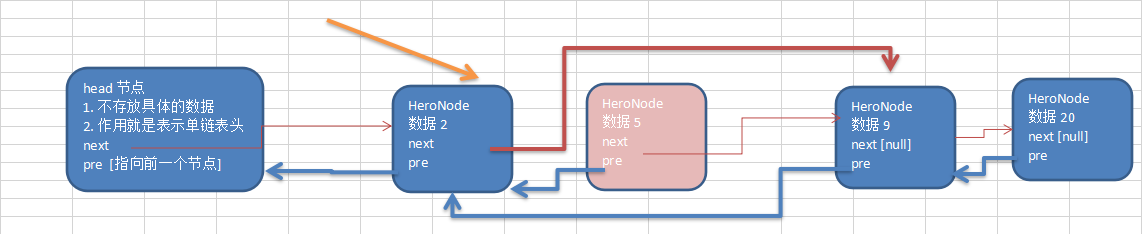
双向链表 概述 管理单向链表的缺点分析 :
单向链表,查找的方向只能是一个方向 ,而双向链表可以向前或者向后查找。
单向链表不能自我删除,需要靠辅助节点 ,而双向链表,则可以自我删除,所以前面我们单链表删除时节点,总是找到 temp,temp是待删除节点的前一个节点(认真体会)。
分析了双向链表如何完成遍历,添加,修改和删除的思路
实例 使用带 head 头的双向链表实现——水浒英雄排行榜
思路分析 双向链表的遍历,添加,修改,删除的操作思路
遍历 方和 单链表一样,只是可以向前,也可以向后查找
添加 (默认添加到双向链表的最后)
先找到双向链表的最后这个节点
temp.next = newHeroNode
newHeroNode.pre = temp;
修改 思路和 原来的单向链表一样.
删除
因为是双向链表,因此,我们可以实现自我删除某个节点
直接找到要删除的这个节点,比如temp
temp.pre.next = temp.next
temp.next.pre = temp.pre;
代码 public class DoubleLinkedListDemo { public static void main (String[] args) { System.out.println("双向链表的测试" ); HeroNode2 hero1 = new HeroNode2 (1 , "宋江" , "及时雨" ); HeroNode2 hero2 = new HeroNode2 (2 , "卢俊义" , "玉麒麟" ); HeroNode2 hero3 = new HeroNode2 (3 , "吴用" , "智多星" ); HeroNode2 hero4 = new HeroNode2 (4 , "林冲" , "豹子头" ); DoubleLinkedList doubleLinkedList = new DoubleLinkedList (); doubleLinkedList.add(hero1); doubleLinkedList.add(hero2); doubleLinkedList.add(hero3); doubleLinkedList.add(hero4); doubleLinkedList.Forwardlist(); System.out.println("双向链表的反向输出" ); doubleLinkedList.Rsvsrselist(); HeroNode2 newHeroNode = new HeroNode2 (4 , "公孙胜" , "入云龙" ); doubleLinkedList.update(newHeroNode); System.out.println("修改后的链表情况" ); doubleLinkedList.Forwardlist(); doubleLinkedList.del(3 ); System.out.println("删除后的链表情况" ); doubleLinkedList.Forwardlist(); } } class DoubleLinkedList { private HeroNode2 head = new HeroNode2 (0 , "" , "" ); public HeroNode2 getHead () { return head; } public void Forwardlist () { if (head.next == null ) { System.out.println("链表为空" ); return ; } HeroNode2 temp = head.next; while (true ) { if (temp == null ) { break ; } System.out.println(temp); temp = temp.next; } } public void Rsvsrselist () { if (head.next == null ) { System.out.println("链表为空" ); return ; } HeroNode2 temp1 = head; HeroNode2 temp2; while (true ) { if (temp1.next == null ) { temp2 = temp1; break ; } temp1 = temp1.next; } while (true ) { if (temp2.pre == null ) { break ; } System.out.println(temp2); temp2 = temp2.pre; } } public void add (HeroNode2 heroNode) { HeroNode2 temp = head; while (true ) { if (temp.next == null ) { break ; } temp = temp.next; } temp.next = heroNode; heroNode.pre = temp; } public void addByOrder (HeroNode2 heroNode) { HeroNode2 temp = head; boolean flag = false ; while (true ) { if (temp.next == null ) { break ; } if (temp.next.no > heroNode.no) { break ; } else if (temp.next.no == heroNode.no) { flag = true ; break ; } temp = temp.next; } if (flag) { System.out.println("准备插入的英雄的编号" + heroNode.no + "已经存在了,不能加入" ); } else { if (temp.next != null ) { heroNode.next = temp.next; temp.next.pre = heroNode; heroNode.pre = temp; temp.next = heroNode; } else { heroNode.pre = temp; temp.next = heroNode; } } } public void update (HeroNode2 newHeroNode) { if (head.next == null ) { System.out.println("链表为空~" ); return ; } HeroNode2 temp = head.next; boolean flag = false ; while (true ) { if (temp == null ) { break ; } if (temp.no == newHeroNode.no) { flag = true ; break ; } temp = temp.next; } if (flag) { temp.name = newHeroNode.name; temp.nickname = newHeroNode.nickname; } else { System.out.printf("没有找到编号%d的节点,不能修改\n" , newHeroNode.no); } } public void del (int no) { if (head.next == null ) { System.out.println("链表为空,无法删除" ); return ; } HeroNode2 temp = head.next; boolean flag = false ; while (true ) { if (temp == null ) { break ; } if (temp.no == no) { flag = true ; break ; } temp = temp.next; } if (flag) { temp.pre.next = temp.next; if (temp.next != null ) { temp.next.pre = temp.pre; } } else { System.out.printf("要删除的" + no + "节点不存在" ); } } } class HeroNode2 { public int no; public String name; public String nickname; public HeroNode2 next; public HeroNode2 pre; public HeroNode2 (int no, String name, String nickname) { this .no = no; this .name = name; this .nickname = nickname; } @Override public String toString () { return "HeroNode [no=" + no + ", name=" + name + ", nickname=" + nickname + "]" ; } }
约瑟夫问题 概述 Josephu问题
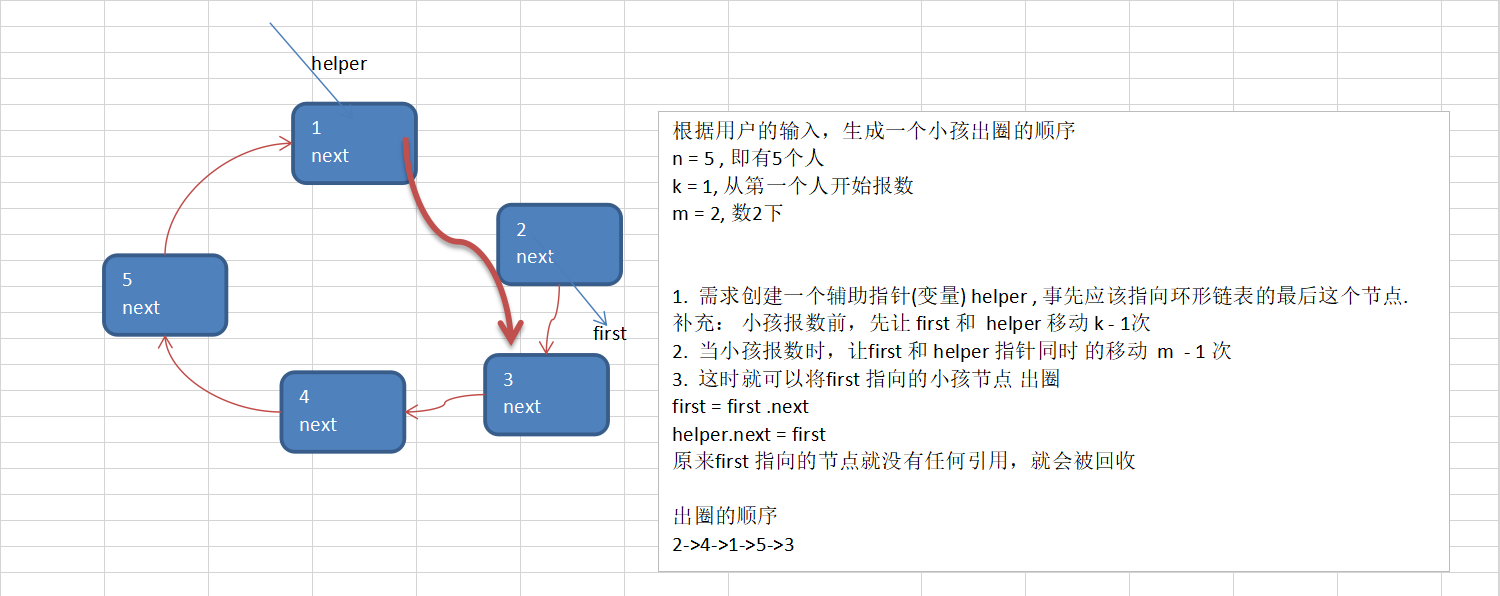
设编号为1,2,…n的n个人围坐一圈,约定编号为k (1<=k<=n) 的人从1开始报数,数到m的那个人出列,它的下一位又从1开始报数,数到m的那个人又出列,依次类推,直到所有人出列为止,由此产生一个出队编号的序列。
提示
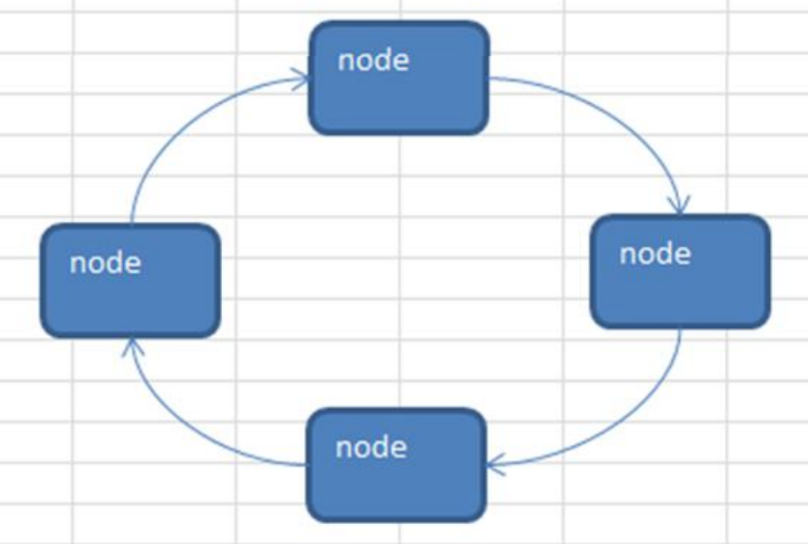
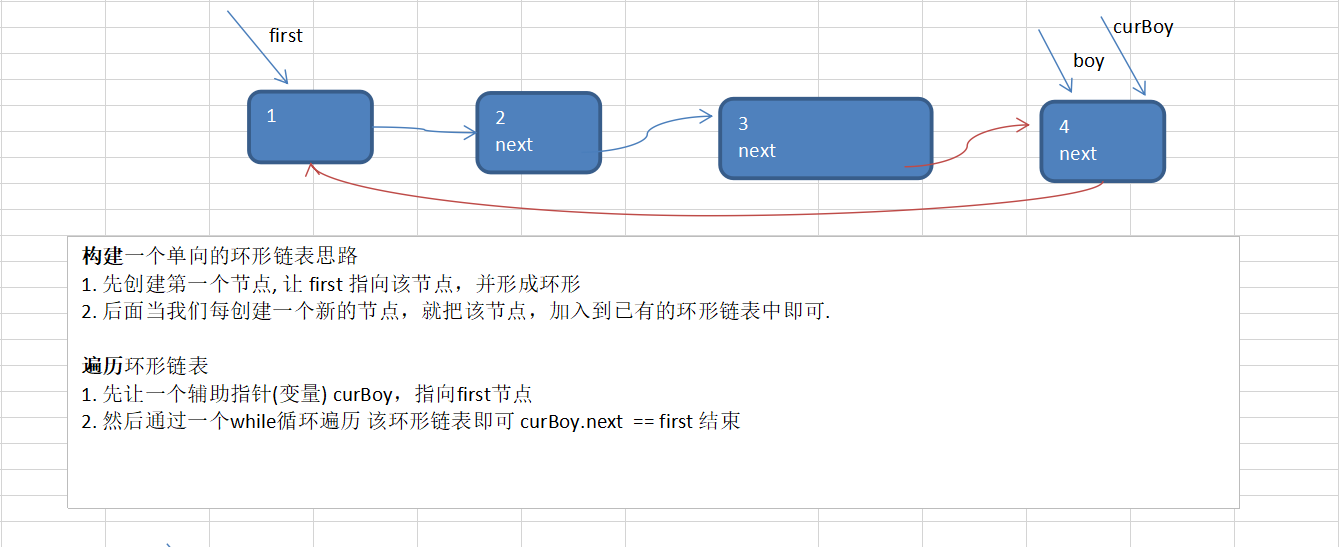
用一个不带头结点的循环链表 来处理Josephu问题:先构成一个有n个结点的单循环链表,然后由k结点起从1开始计数,计到m时,对应结点从链表中删除,然后再从被删除结点的下一个结点又从1开始计数,直到最后一个结点从链表中删除算法结束。
实例 思路分析
约瑟夫问题——小孩出圈的思路分析图
代码 public class Josepfu { public static void main (String[] args) { CircleSingleLinkedList circleSingleLinkedList = new CircleSingleLinkedList (); circleSingleLinkedList.addBoy(5 ); circleSingleLinkedList.showBoy(); circleSingleLinkedList.countBoy(1 , 2 , 5 ); } } class CircleSingleLinkedList { private Boy first = null ; public void addBoy (int nums) { if (nums < 1 ){ System.out.println("num的值不正确" ); return ; } Boy curBoy = null ; for (int i = 1 ;i <= nums;i++){ Boy boy = new Boy (i); if (i == 1 ){ first = boy; first.setNext(first); curBoy = first; }else { curBoy.setNext(boy); boy.setNext(first); curBoy = boy; } } } public void countBoy (int startNo, int countNum,int nums) { if (first == null || startNo < 1 || startNo > nums) { System.out.println("参数输入有误, 请重新输入" ); return ; } Boy helper = first; while (true ) { if (helper.getNext() == first) { break ; } helper = helper.getNext(); } for (int j = 0 ; j < startNo - 1 ; j++) { first = first.getNext(); helper = helper.getNext(); } while (true ) { if (helper == first) { break ; } for (int j = 0 ; j < countNum - 1 ; j++) { first = first.getNext(); helper = helper.getNext(); } System.out.printf("小孩%d 出圈\n" , first.getNo()); first = first.getNext(); helper.setNext(first); } System.out.printf("最后留在圈中的小孩编号%d \n" , first.getNo()); } public void showBoy () { if (first == null ) { System.out.println("没有任何小孩" ); return ; } Boy curBoy = first; while (true ) { System.out.printf("小孩的编号 %d \n" , curBoy.getNo()); if (curBoy.getNext() == first) { break ; } curBoy = curBoy.getNext(); } } } class Boy { private int no; private Boy next; public Boy (int no) { this .no = no; } public int getNo () { return no; } public void setNo (int no) { this .no = no; } public Boy getNext () { return next; } public void setNext (Boy next) { this .next = next; } }
栈 概述 介绍
栈的英文为(stack)
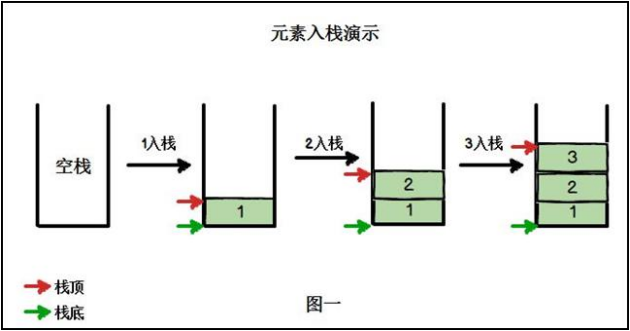
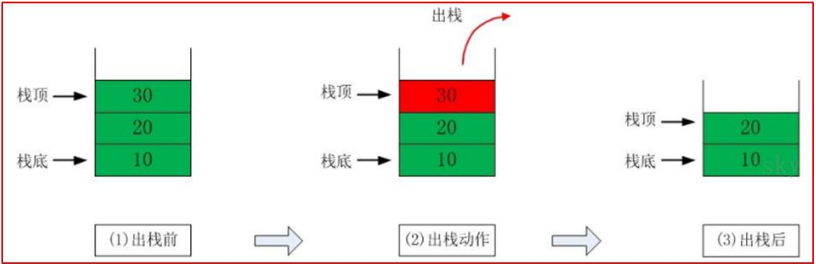
栈是一个==先入后出==(FILO-First In Last Out)的有序列表。 栈(stack)是限制线性表中元素的插入和删除只能在线性表的同一端进行的一种特殊线性表。允许插入和删除的一端,为==变化的一端,称为栈顶(Top)==,==另一端为固定的一端, 称为栈底(Bottom)==。 根据栈的定义可知,最先放入栈中元素在栈底,最后放入的元素在栈项,而删除元素刚好相反,最后放入的元素最先删除,最先放入的元素最后删除。 图解方式说明出栈(pop)和入栈(push)的概念。
应用场景
子程序的调用:在跳往子程序前,会先将下个指令的地址存到堆栈中,直到子程序执行完后再将地址取出,以回到原来的程序中。
处理递归调用:和子程序的调用类似,只是除了储存下一个指令的地址外,也将参数、区域变量等数据存入堆栈中。
表达式的转换【中缀表达式转后缀表达式】与求值(实际解决)。
二叉树的遍历。
图形的深度优先(depth一first)搜索法。
快速入门 用数组模拟栈的使用
由于栈是一种有序列表,当然可以使用数组的结构来储存栈的数据内容,下面我们就用数组模拟栈的出栈,入栈等操作。
思路分析
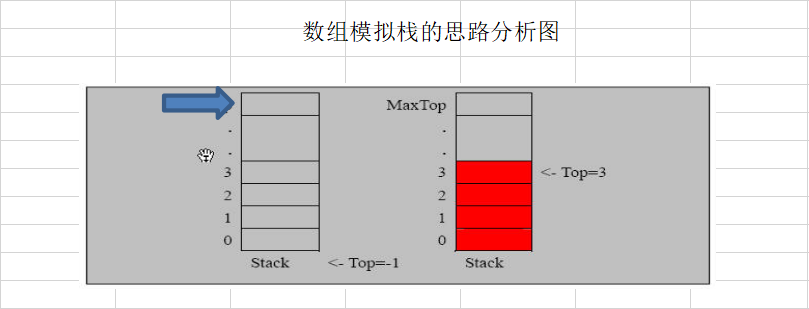
实现栈的思路分析:
使用数组来模拟栈。
定义一个top来表示栈顶,初始化为-1。
入栈 的操作,当有数据加入到栈时,top++;stack[top] = data;出栈 的操作,int value = stack[top];top–,return value
代码实现 数组实现
class ArrayStack { private int maxSize; private int [] stack; private int top = -1 ; public ArrayStack (int maxSize) { this .maxSize = maxSize; stack = new int [this .maxSize]; } public boolean isFull () { return top == maxSize-1 ; } public boolean isEmpty () { return top == -1 ; } public void push (int value) { if (isFull()){ System.out.println("栈已满,不能再放数据" ); return ; } top ++; stack[top] = value; } public int pop () { if (isEmpty()){ throw new RuntimeException ("栈空,没有数据" ); } int tmp = stack[top]; top--; return tmp; } public void list () { if (isEmpty()){ System.out.println("栈空" ); return ; } for (int i = top; i >= 0 ; i--){ System.out.printf("stack[" +i+"]=" +stack[i]); } } }
队列实现
class DListStack { private Node top = new Node (0 ); private int maxSize; private Node tail; public DListStack (int maxsize) { this .maxSize = maxsize; tail = top; for (int i = 0 ; i < maxsize; i++) { Node tmp = new Node (0 ); tail.next = tmp; tmp.prev = tail; tail = tail.next; } } public boolean isEmpty () { if (top.no == 0 ) { return true ; } return false ; } public boolean isFull () { return tail == top; } public void list () { if (isEmpty()) { System.out.println("栈为空" ); return ; } Node tmp = top; while (tmp.no != 0 ) { System.out.println(tmp.no); tmp = tmp.prev; } } public void push (int value) { if (isFull()){ System.out.println("栈已满" ); return ; } top = top.next; top.no = value; } public int pop () { if (isEmpty()) { System.out.println("栈已空" ); return 0 ; } int no = top.no; top = top.prev; return no; } } class Node { public int no; public Node next; public Node prev; public Node (int no) { this .no = no; } @Override public String toString () { return "" + no; } }
方法类
public class StackTestDemo { public static void main (String[] args) { ArrayStack arrayStack = new ArrayStack (4 ); DListStack dListStack = new DListStack (4 ); String key = "" ; boolean loop = true ; Scanner scanner = new Scanner (System.in); while (loop) { System.out.println("show:表示显示栈" ); System.out.println("exit:表示退出程序" ); System.out.println("push:表示入栈" ); System.out.println("pop:表示出栈" ); System.out.println("请输入你的选择" ); key = scanner.next(); switch (key) { case "show" : dListStack.list(); break ; case "exit" : if (scanner != null ) { scanner.close(); } loop = false ; break ; case "push" : System.out.println("请输入一个数" ); int value = scanner.nextInt(); dListStack.push(value); break ; case "pop" : try { int res = dListStack.pop(); System.out.println("出栈的元素是" + res); } catch (Exception e) { e.printStackTrace(); } break ; } } } }
综合计算器(中缀) 使用栈完成表达式的计算
中缀表达式 : 或中缀记法)是一个通用的算术或逻辑公式表示方法, 操作符是以中缀形式处于操作数的中间(例:3 + 4),中缀表达式是人们常用的算术表示方法。
思路分析
通过一个index值(索引),来遍历我们的表达式;
如果我们发现是一个数字 ,就直接入数栈;
如果发现扫描到是一个符号 ,就分如下情况:
如果发现当前的符号栈为空,就直接入栈
如果符号栈有操作符,就进行比较
当表达式扫描完毕,就顺序的从数栈和符号栈中pop出相应的数和符号,并运行 ;
最后在数栈只有一个数字,就是表达式的结果。
补充:当运算式中有多位数时,先判断具体数字是多少,再判断数字
代码实现 public class ComputerTest { public static void main (String[] args) { String expression = "70+2*6-4" ; NumStack numStack = new NumStack (10 ); NumStack operStack = new NumStack (10 ); int index = 0 ; int num1 = 0 ; int num2 = 0 ; int oper = 0 ; int res = 0 ; char ch = ' ' ; String keepNum = "" ; while (true ) { ch = expression.substring(index, index + 1 ).charAt(0 ); if (operStack.isOper(ch)) { if (!operStack.isEmpty()) { if (operStack.priority(ch) <= operStack.priority(operStack.peek())) { num1 = numStack.pop(); num2 = numStack.pop(); oper = operStack.pop(); res = operStack.cal(num1, num2, oper); numStack.push(res); operStack.push(ch); } else { operStack.push(ch); } } else { operStack.push(ch); } } else { keepNum += ch; if (index + 1 == expression.length()) { numStack.push(ch - 48 ); } else { if (operStack.isOper(expression.substring(index + 1 , index + 2 ).charAt(0 ))) { numStack.push(Integer.parseInt(keepNum)); keepNum = "" ; } } } index++; if (index >= expression.length()) { break ; } } while (true ) { if (operStack.isEmpty()) { break ; } num1 = numStack.pop(); num2 = numStack.pop(); oper = operStack.pop(); res = numStack.cal(num1, num2, oper); numStack.push(res); } res = numStack.pop(); System.out.printf("表达式%s = %d" , expression, res); } } class NumStack { private int maxSize; private int [] stack; private int top = -1 ; public NumStack (int maxSize) { this .maxSize = maxSize; stack = new int [this .maxSize]; } public boolean isFull () { return top == maxSize - 1 ; } public int peek () { return stack[top]; } public boolean isEmpty () { return top == -1 ; } public void push (int value) { if (isFull()) { System.out.println("栈已满,不能再放数据" ); return ; } top++; stack[top] = value; } public int pop () { if (isEmpty()) { throw new RuntimeException ("栈空,没有数据" ); } int tmp = stack[top]; top--; return tmp; } public void list () { if (isEmpty()) { System.out.println("栈空" ); return ; } for (int i = top; i >= 0 ; i--) { System.out.printf("stack[%d]=%d\n" , i, stack[i]); } } public int priority (int oper) { if (oper == '*' || oper == '/' ) { return 1 ; } else if (oper == '+' || oper == '-' ) { return 0 ; } else { return -1 ; } } public boolean isOper (char val) { return val == '+' || val == '-' || val == '*' || val == '/' ; } public int cal (int num1, int num2, int oper) { int res = 0 ; switch (oper) { case '+' : res = num1 + num2; break ; case '-' : res = num2 - num1; break ; case '*' : res = num1 * num2; break ; case '/' : res = num2 / num1; break ; default : break ; } return res; } }
前缀、中缀、后缀表达式 前缀表达式(波兰表达式) 概述
前缀表达式又称波兰式,前缀表达式的运算符位于操作数之前
举例说明:(3+4)X5-6 对应的前缀表达式就是 - X + 3 4 5 6
思路 前缀表达式的计算机求值
丛右至左扫描表达式,遇到数字时,将数字压入堆栈,遇到运算符时,弹出栈项的两个数,用运算符对它们做相应的计算(栈顶元素和次顶元素),并将结果入栈;重复上述过程直到表达式最左端,最后运算得出的值即为表达式的结果
例如:(3+4)X 5-6对应的前缀表达式就是 - X + 3 4 5 6,针对前缀表达式求值步骤如下:
从右至左扫描,将6、5、4、3压入堆栈;
遇到+运算符,因此弹出3和4 (3为栈项元素,4为次顶元素),计算出3+4的值,得7,再将7入栈;
接下来是X运算符,因此弹出7和5,计算出7X5=35,将35入栈;
最后是 - 运算符,计算出35-6的值,即29, 由此得出最终结果。
中缀表达式
中缀表达式就是常见的运算表达式,如(3+4)X5-6;
中缀表达式的求值是我们人最熟悉的,但是对计算机来说却不好操作(前面我们讲的案例就能看的这个问题),因此,在计算结果时,往往会将中缀表达式转成其它表达式来操作(一般转成后缀表达式)。
后缀表达式
后缀表达式又称逆波兰表达式与前缀表达式相似,只是运算符位于操作数之后;
中举例说明:(3+4)X5-6对应的后缀表达式就是3 4 + 5 X 6 -
后缀表达式的计算机求值
从左至右扫描表达式,遇到数字时,将数字压入堆栈,遇到运算符时,弹出栈项的两个数,用运算符对它们做相应的计算(次项元素和栈项元素),并将结果入栈;重复上述过程直到表达式最右端,最后运算得出的值即为表达式的结果
例如:(3+4)X5-6对应的前缀表达式就是 3 4 + 5 X 6 -,针对后缀表达式求值步骤如下:
从左至右扫描,将3和4压入堆栈;
遇到+运算符, 因此弹出4和3 (4为栈项元素,3为次顶元素),计算出3+4的值,得7,再将7入栈;
将5入栈;
接下来是X运算符,因此弹出5和7,计算出7X5=35,将35入栈;
将6入栈;
最后是 - 运算符,计算出35-6的值,即29,由此得出最终结果。
逆波兰计算器 我们完成-一个逆波兰计算器,要求完成如下任务:
输入一个逆波兰表达式,使用栈(Stack),计算其结果
支持小括号和多位数整数,因为这里我们主要讲的是数据结构,因此计算器进行简化,只支持对整数的计算。
思路分析
代码完成
思路分析 详见后缀表达式
实现 public class PolandNotation { public static void main (String[] args) { String suffExpression = "3 4 + 5 x 6 -" ; List<String> lst = getListString(suffExpression); System.out.println(lst); int result = calculate(lst); System.out.println("逆波兰表达式的结果为:" + result); } public static List<String> getListString (String suffixExpression) { String[] arr = suffixExpression.split(" " ); List<String> lst = new ArrayList <>(); for (String item : arr) { lst.add(item); } return lst; } public static int calculate (List<String> lst) { Stack<String> stack = new Stack <>(); for (String lst1 : lst) { if (lst1.matches("\\d+" )) { stack.push(lst1); } else { int num2 = Integer.parseInt(stack.pop()); int num1 = Integer.parseInt(stack.pop()); int res = 0 ; if (lst1.equals("+" )) { res = num1 + num2; } else if (lst1.equals("-" )) { res = num1 - num2; } else if (lst1.equals("x" )) { res = num1 * num2; } else if (lst1.equals("/" )) { res = num1/ num2; } else { throw new RuntimeException ("运算符有误" ); } stack.push("" + res); } } return Integer.parseInt(stack.pop()); } }
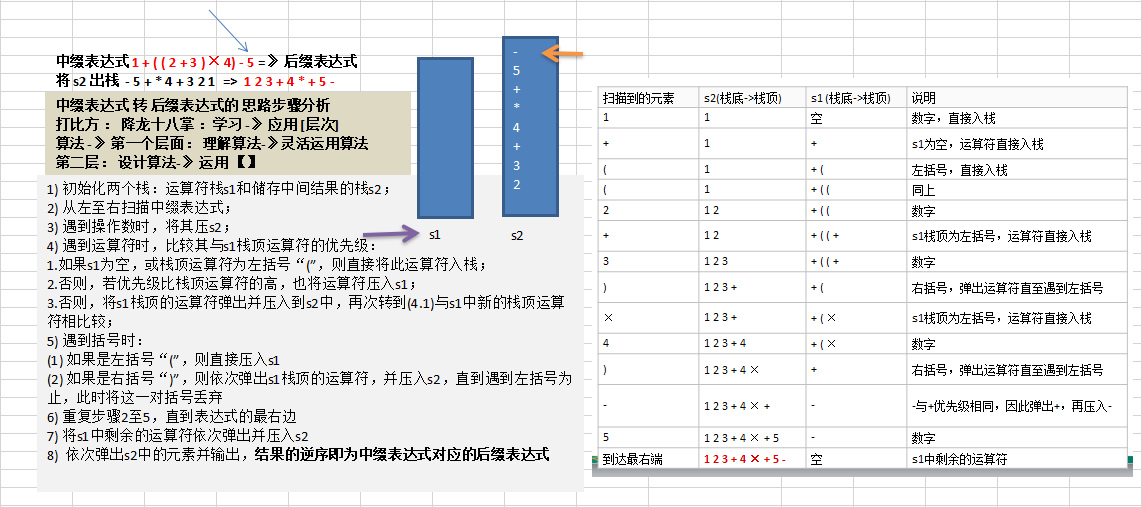
中缀表达式转换为后缀表达式 后缀表达式适合计算机式进行运算 ,但是却不太容易写出来,尤其是表达式很长的情况下,因此在开发中,我们需要将中缀表达式转成后缀表达式。
思路分析
初始化两个栈:运算符栈s1和储存中间结果的栈s2;
从左至右扫描中缀表达式;
遇到操作数时,将其压s2;
遇到运算符时,比较其与s1栈顶运算符的优先级:
如果s1为空,或栈顶运算符为左括号“(”,则直接将此运算符入栈;
否则,若优先级比栈顶运算符的高,也将运算符压入s1;
否则,将s1栈顶的运算符弹出并压入到s2中,再次转到(4.1)与s1中新的栈顶运算符相比较;
遇到括号时:
如果是左括号“(”,则直接压入s1;
如果是右括号“)”,则依次弹出s1栈顶的运算符,并压入s2,直到遇到左括号为止,此时将这一对括号丢弃;
重复步骤2至5,直到表达式的最右边;
将s1中剩余的运算符依次弹出并压入s2;
依次弹出s2中的元素并输出,结果的逆序即为中缀表达式对应的后缀表达式;
核心方法实现 将中缀表达式转成对应的list
public static List<String> toInfixExpressionList (String s) { List<String> list = new ArrayList <String>(); int i = 0 ; String string; char c; do { if ((c = s.charAt(i)) < 48 || (c = s.charAt(i)) > 57 ) { list.add("" + c); i++; } else { string = "" ; while (i < s.length() && (c = s.charAt(i)) > 48 && (c = s.charAt(i)) < 57 ) { string += c; i++; } list.add(string); } } while (i < s.length()); return list; }
将得到的中缀表达式对应的list转换为对应的后缀表达式
public static List<String> ParseSuffixExpressionList (List<String> list) { Stack<String> stack1 = new Stack <String>(); List stack2 = new ArrayList <String>(); for (String item : list) { if (item.matches("\\d+" )) { stack2.add(item); } else if (item.equals("(" )) { stack1.push(item); } else if (item.equals(")" )) { while (!stack1.peek().equals("(" )) { stack2.add(stack1.pop()); } stack1.pop(); } else { while (stack1.size() != 0 && Operation.getValue(stack1.peek()) >= Operation.getValue(item)) { stack2.add(stack1.pop()); } stack1.push(item); } } while (stack1.size() != 0 ) { stack2.add(stack1.pop()); } return stack2; }
编写一个Operation类,可以返回一个运算符对应的优先级
class Operation { private static int ADD = 1 ; private static int SUB = 1 ; private static int MUL = 2 ; private static int DIV = 2 ; public static int getValue (String operation) { int result = 0 ; switch (operation) { case "+" : result = ADD; break ; case "-" : result = SUB; break ; case "x" : result = MUL; break ; case "/" : result = DIV; break ; default : System.out.println("不存在该运算符" ); break ; } return result; } }
测试类
public static void main (String[] args) { String expression = "(3+4)x5-6" ; List<String> infisExpressionList = toInfixExpressionList(expression); List<String> parseSuffixExpressionList = ParseSuffixExpressionList(infisExpressionList); System.out.println(parseSuffixExpressionList); int result = calculate(parseSuffixExpressionList); System.out.println("结果为:" + result); }
完整代码 import java.util.ArrayList;import java.util.List;import java.util.Stack;public class PolandNotation { public static void main (String[] args) { String expression = "(3+4)x5-6" ; List<String> infisExpressionList = toInfixExpressionList(expression); List<String> parseSuffixExpressionList = ParseSuffixExpressionList(infisExpressionList); System.out.println(parseSuffixExpressionList); int result = calculate(parseSuffixExpressionList); System.out.println("逆波兰表达式的结果为:" + result); } public static List<String> ParseSuffixExpressionList (List<String> list) { Stack<String> stack1 = new Stack <String>(); List stack2 = new ArrayList <String>(); for (String item : list) { if (item.matches("\\d+" )) { stack2.add(item); } else if (item.equals("(" )) { stack1.push(item); } else if (item.equals(")" )) { while (!stack1.peek().equals("(" )) { stack2.add(stack1.pop()); } stack1.pop(); } else { while (stack1.size() != 0 && Operation.getValue(stack1.peek()) >= Operation.getValue(item)) { stack2.add(stack1.pop()); } stack1.push(item); } } while (stack1.size() != 0 ) { stack2.add(stack1.pop()); } return stack2; } public static List<String> toInfixExpressionList (String s) { List<String> list = new ArrayList <String>(); int i = 0 ; String string; char c; do { if ((c = s.charAt(i)) < 48 || (c = s.charAt(i)) > 57 ) { list.add("" + c); i++; } else { string = "" ; while (i < s.length() && (c = s.charAt(i)) > 48 && (c = s.charAt(i)) < 57 ) { string += c; i++; } list.add(string); } } while (i < s.length()); return list; } public static int calculate (List<String> lst) { Stack<String> stack = new Stack <>(); for (String lst1 : lst) { if (lst1.matches("\\d+" )) { stack.push(lst1); } else { int num2 = Integer.parseInt(stack.pop()); int num1 = Integer.parseInt(stack.pop()); int res = 0 ; if (lst1.equals("+" )) { res = num1 + num2; } else if (lst1.equals("-" )) { res = num1 - num2; } else if (lst1.equals("x" )) { res = num1 * num2; } else if (lst1.equals("/" )) { res = num1 / num2; } else { throw new RuntimeException ("运算符有误" ); } stack.push("" + res); } } return Integer.parseInt(stack.pop()); } } class Operation { private static int ADD = 1 ; private static int SUB = 1 ; private static int MUL = 2 ; private static int DIV = 2 ; public static int getValue (String operation) { int result = 0 ; switch (operation) { case "+" : result = ADD; break ; case "-" : result = SUB; break ; case "x" : result = MUL; break ; case "/" : result = DIV; break ; default : System.out.println("不存在该运算符" ); break ; } return result; } }
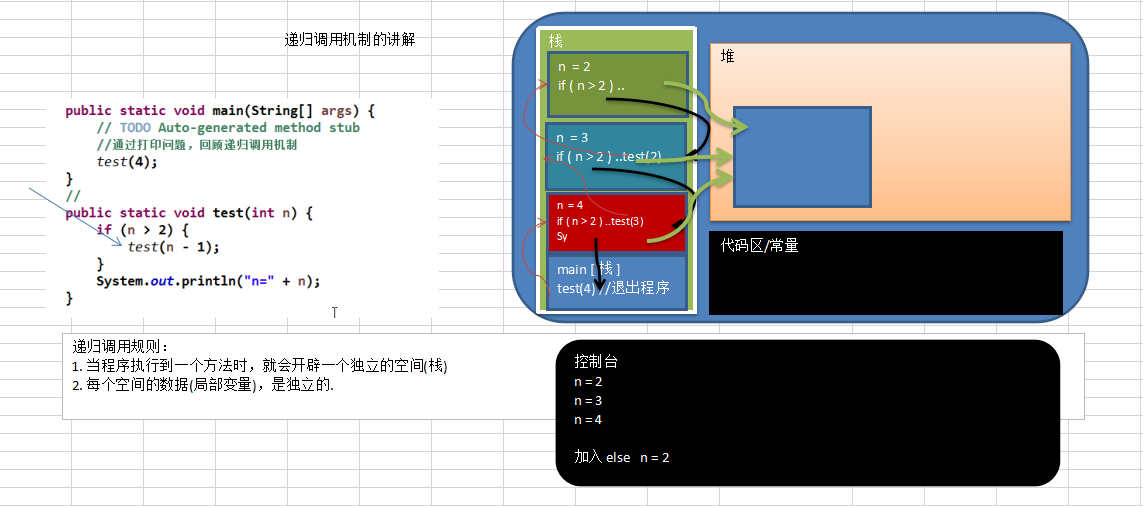
递归 递归就是方法自己调用自己,每次调用时传入不同的变量,递归有助于编程者解决复杂的问题 ,同时可以让代码变得简洁。
递归调用规则:
**当程序执行到一个方法时,就会开辟一个独立的空间(栈)**。
每个空间的数据(局部变量),是独立的。
递归能解决什么样的问题
各种数学问题如:8 皇后问题,汉诺塔,阶乘问题,迷宫问题,球和篮子的问题(google编程大赛)。
各 种算法中也会使用到递归,比如快排,归并排序,二分查找,分治算法等。
将用栈解决的问题转换为用归代码,比较简洁。
递归需要遵守的重要规则
执行一个方法时,就创建一个新的受保护的独立空间(栈空间);
方法的局部变量是独立的,不会相互影响,比如n变量;
如果方法中使用的是引用类型变量(比如数组),就会共享该引用类型的数据;
递归必须向退出递归的条件逼近, 否则就是无限递归,出现栈溢出(StackOverflowError),死龟了:)
当一个方法执行完毕,或者遇到return,就会返回,遵守谁调用,就将结果返回给谁,同时当方法执行完毕或者返回时,该方法也就执行完毕。
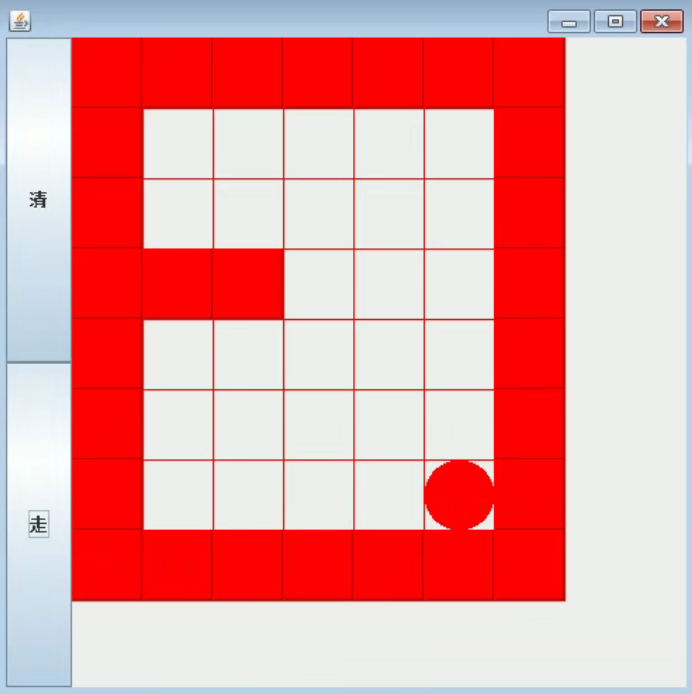
迷宫回溯
小球得到的路径,和程序员设置的找路策略有关即:找路的上下左右的顺序相关
再得到小球路径时,可以先使用(下右上左),再改成(上右下左),看看路径是不是有变化
测试回溯现象
思考: 如何求出最短路径?
采取不同策略,将结果用list集合存起来,然后将不同策略算出的不同结果进行比较。
思路分析
map 表示地图;
i,j 表示从地图的哪个位置开始出发 (1,1);
如果小球能到 map[6][5] 位置,则说明通路找到;
约定: 当map[i][j] 为 0 表示该点没有走过; 当为 1 表示墙 ; 2 表示通路可以走 ; 3 表示该点已经走过,但是走不通;
在走迷宫时,需要确定一个策略(方法) 下->右->上->左 , 如果该点走不通,再回溯;
代码实现 public class MiGong { public static void main (String[] args) { int [][] map = new int [8 ][7 ]; for (int i = 0 ; i < 7 ; i++) { map[0 ][i] = 1 ; map[7 ][i] = 1 ; } for (int i = 1 ; i < 7 ; i++) { map[i][0 ] = 1 ; map[i][6 ] = 1 ; } map[3 ][1 ] = 1 ; map[3 ][2 ] = 1 ; System.out.println("地图的情况~~" ); for (int i = 0 ; i < 8 ; i++) { for (int j = 0 ; j < 7 ; j++) { System.out.print(map[i][j] + "\t" ); } System.out.println(); } setWay(map, 1 , 1 ); System.out.println("迷宫问题路径地图的情况~~" ); for (int i = 0 ; i < 8 ; i++) { for (int j = 0 ; j < 7 ; j++) { System.out.print(map[i][j] + "\t" ); } System.out.println(); } } public static boolean setWay (int [][] map, int i, int j) { if (map[6 ][5 ] == 2 ) { return true ; } else { if (map[i][j] == 0 ) { map[i][j] = 2 ; if (setWay(map, i + 1 , j)) { return true ; } else if (setWay(map, i, j + 1 )) { return true ; } else if (setWay(map, i - 1 , j)) { return true ; } else if (setWay(map, i, j - 1 )) { return true ; } else { map[i][j] = 3 ; return false ; } } else { return false ; } } } public static boolean setWay2 (int [][] map, int i, int j) { if (map[6 ][5 ] == 2 ) { return true ; } else { if (map[i][j] == 0 ) { map[i][j] = 2 ; if (setWay2(map, i - 1 , j)) { return true ; } else if (setWay2(map, i, j + 1 )) { return true ; } else if (setWay2(map, i + 1 , j)) { return true ; } else if (setWay2(map, i, j - 1 )) { return true ; } else { map[i][j] = 3 ; return false ; } } else { return false ; } } } }
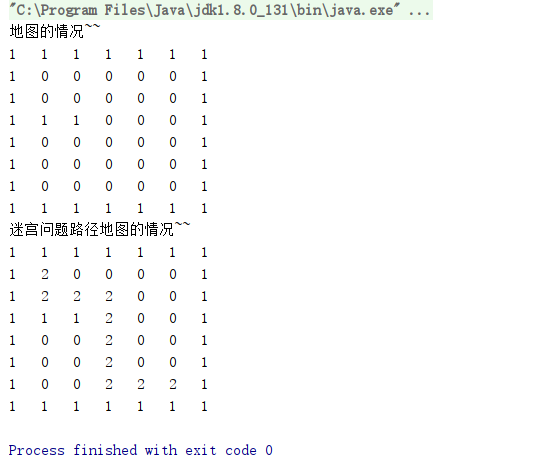
运行结果
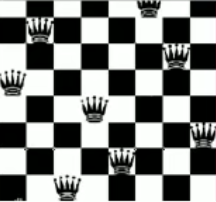
八皇后问题 八皇后问题,是一个古老而著名的问题,是回溯算法的典型案例。该问题是:在8×8格的国际象棋上摆放八个皇后,使其不能互相攻击,即:任意两个皇后都不能处于同一行、同一列或同一斜线上,问有多少种摆法 。
思路分析
第一个皇后先放第一行第一列
第二个皇后放在第二行第一列、然后判断是否发生冲突。 如果有冲突,就把它放在第二列、第三列、依次把所有列都放完,找到一个合适的位置
继续第三个皇后,还是第一列、第二列……直到第8个皇后也能放在一个不冲突的位置。这就算是找到了一个正确解
当得到一个正确解时,就继续改变皇后的位置(即:除第一个皇后外的每一个皇后,把在每一个位置上的所有情况全部运行一遍),继续回溯。直到将第一个皇后,在第一列上时,所有出现的正确解,全部得到
然后从头重新开始,将第一个皇后放在第二列,后面继续循环执行 1,2,3,4的步骤
说明:理论上应该创建一个二维数组来表示棋盘,但是实际上可以通过算法,用一个一维数组即可解决问题。
arr[8]={0,4,7,5,2,6,1,3}//对应arr下标,表示第i+1个皇后在第i+1行的a[i]列
代码实现 public class EightQueue { int max = 8 ; int [] array = new int [max]; static int count = 0 ; static int judgeCount = 0 ; public static void main (String[] args) { EightQueue queue8 = new EightQueue (); queue8.check(0 ); System.out.println("一共有" + count + "解法" ); System.out.println(); System.out.println("一共判断冲突的次数" + judgeCount + "次" ); } private void check (int n) { if (n == max) { print(); return ; } for (int i = 0 ; i < max; i++) { array[n] = i; if (judge(n)) { check(n + 1 ); } } } private boolean judge (int n) { judgeCount++; for (int a = 0 ; a < n; a++) { if (array[a] == array[n] || Math.abs(n - a) == Math.abs(array[n] - array[a])) { return false ; } } return true ; } private void print () { count++; for (int i = 0 ; i < array.length; i++) { System.out.print(array[i] + " " ); } System.out.println(); } }
运行结果
0 4 7 5 2 6 1 3
0 5 7 2 6 3 1 4
0 6 3 5 7 1 4 2
0 6 4 7 1 3 5 2
1 3 5 7 2 0 6 4
1 4 6 0 2 7 5 3
1 4 6 3 0 7 5 2
1 5 0 6 3 7 2 4
1 5 7 2 0 3 6 4
1 6 2 5 7 4 0 3
1 6 4 7 0 3 5 2
1 7 5 0 2 4 6 3
2 0 6 4 7 1 3 5
2 4 1 7 0 6 3 5
2 4 1 7 5 3 6 0
2 4 6 0 3 1 7 5
2 4 7 3 0 6 1 5
2 5 1 4 7 0 6 3
2 5 1 6 0 3 7 4
2 5 1 6 4 0 7 3
2 5 3 0 7 4 6 1
2 5 3 1 7 4 6 0
2 5 7 0 3 6 4 1
2 5 7 0 4 6 1 3
2 5 7 1 3 0 6 4
2 6 1 7 4 0 3 5
2 6 1 7 5 3 0 4
2 7 3 6 0 5 1 4
3 0 4 7 1 6 2 5
3 0 4 7 5 2 6 1
3 1 4 7 5 0 2 6
3 1 6 2 5 7 0 4
3 1 6 2 5 7 4 0
3 1 6 4 0 7 5 2
3 1 7 4 6 0 2 5
3 1 7 5 0 2 4 6
3 5 0 4 1 7 2 6
3 5 7 1 6 0 2 4
3 5 7 2 0 6 4 1
3 6 0 7 4 1 5 2
3 6 2 7 1 4 0 5
3 6 4 1 5 0 2 7
3 6 4 2 0 5 7 1
3 7 0 2 5 1 6 4
3 7 0 4 6 1 5 2
3 7 4 2 0 6 1 5
4 0 3 5 7 1 6 2
4 0 7 3 1 6 2 5
4 0 7 5 2 6 1 3
4 1 3 5 7 2 0 6
4 1 3 6 2 7 5 0
4 1 5 0 6 3 7 2
4 1 7 0 3 6 2 5
4 2 0 5 7 1 3 6
4 2 0 6 1 7 5 3
4 2 7 3 6 0 5 1
4 6 0 2 7 5 3 1
4 6 0 3 1 7 5 2
4 6 1 3 7 0 2 5
4 6 1 5 2 0 3 7
4 6 1 5 2 0 7 3
4 6 3 0 2 7 5 1
4 7 3 0 2 5 1 6
4 7 3 0 6 1 5 2
5 0 4 1 7 2 6 3
5 1 6 0 2 4 7 3
5 1 6 0 3 7 4 2
5 2 0 6 4 7 1 3
5 2 0 7 3 1 6 4
5 2 0 7 4 1 3 6
5 2 4 6 0 3 1 7
5 2 4 7 0 3 1 6
5 2 6 1 3 7 0 4
5 2 6 1 7 4 0 3
5 2 6 3 0 7 1 4
5 3 0 4 7 1 6 2
5 3 1 7 4 6 0 2
5 3 6 0 2 4 1 7
5 3 6 0 7 1 4 2
5 7 1 3 0 6 4 2
6 0 2 7 5 3 1 4
6 1 3 0 7 4 2 5
6 1 5 2 0 3 7 4
6 2 0 5 7 4 1 3
6 2 7 1 4 0 5 3
6 3 1 4 7 0 2 5
6 3 1 7 5 0 2 4
6 4 2 0 5 7 1 3
7 1 3 0 6 4 2 5
7 1 4 2 0 6 3 5
7 2 0 5 1 4 6 3
7 3 0 2 5 1 6 4
一共有92解法

一共判断冲突的次数15720次
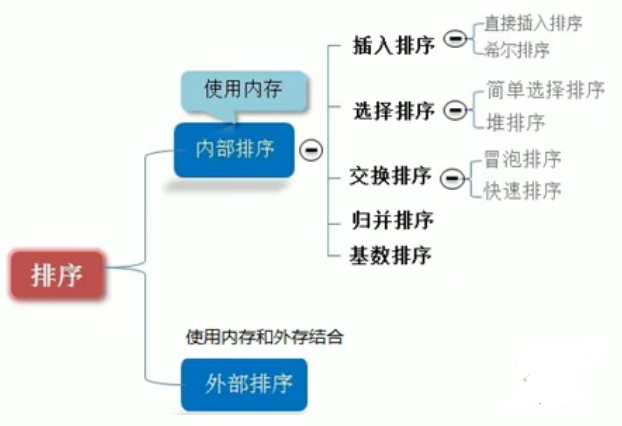
排序算法 排序也称排序算法(Sort Algorithm), 排序是将一组数据,依指定的顺序进行排列的过程。
排序的分类
内部排序:
指将需要处理的所有数据都加载到内部存储器(内存) 中进行排序。
外部排序法:
数据量过大 ,无法全部加载到内存中,需要借助外部存储进行排序。
常见的排序算法分类
算法的时间复杂度 度量一个程序(算法)执行时间的两种方法
事后统计的方法
这种方法可行,但是有两个问题:
一是要想对设计的算法的运行性能进行评测,需要实际运行该程序;
二是所得时间的统计量依赖于计算机的硬件、软件等环境因素,这种方式,要在同一台计算机的相同状态下运行,才能比较那个算法速度更快。
事前估算的方法
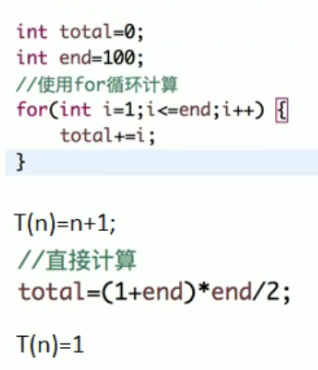
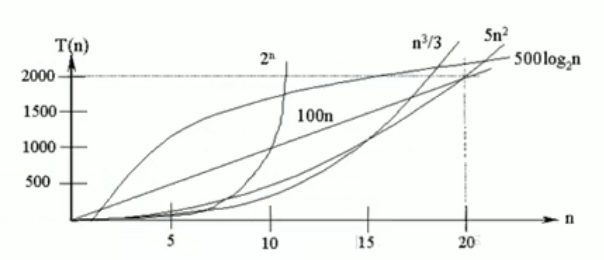
时间频度 一个算法花费的时间与算法中语句的执行次数成正比例,哪个算法中语句执行次数多,它花费时间就多。一个算法中的语句执行次数称为语句频度或时间频度 。记为T(n)。
举例说明
计算1-100所有数字之和,我们设计两种算法:
特点
随着n的增大,可以忽略常数项、忽略低次项、忽略系数
时间复杂度
一般情况下,算法中的基本操作语句的重复执行次数是问题规模n的某个函数 ,用T(n)表示,若有某个辅助函数f(n),使得当n趋近于无穷大时,T(n) /f(n)的极限值为不等于零的常数,则称f(n)是T(n)的同数量级函数。 记作T(n)= 0(f(n)),称O(f(n)) 为算法的渐进时间复杂度,简称时间复杂度。
T(n)不同,但时间复杂度可能相同。如: T(n)=n2 +7n+6与T(n)=3n2 +2n+2它们的T(n)不同,但时间复杂度相同,都为0(n2 )。
计算时间复杂度的方法:
用常数1代替运行时间中的所有加法常数T(n)=n2 +7n+6 =>T(n)=n2 +7n+1
修改后的运行次数函数中,只保留最高阶项T(n)=n2 +7n+1=>T(n)=n22
去除最高阶项的系数T(n)=n2 => T(n)= n2 => O(n2 )
平均时间复杂度和最坏时间复杂度
平均时间复杂度是指所有可能的输入实例均以等概率出现的情况下,该算法的运行时间。
最坏情况下的时间复杂度称最坏时间复杂度。一般讨论的时间复杂度均是最坏情况下的时间复杂度。这样做的原因是:最坏情况下的时间复杂度是算法在任何输入实例上运行时间的界限,这就保证了算法的运行时间不会比最坏情况更长。
平均时间复杂度和最坏时间复杂度是否一致,和算法有关。
常见的时间复杂度
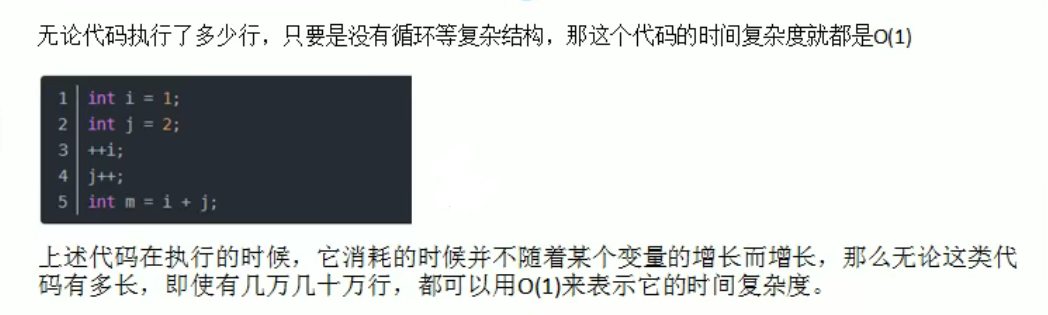
常数阶O(1)
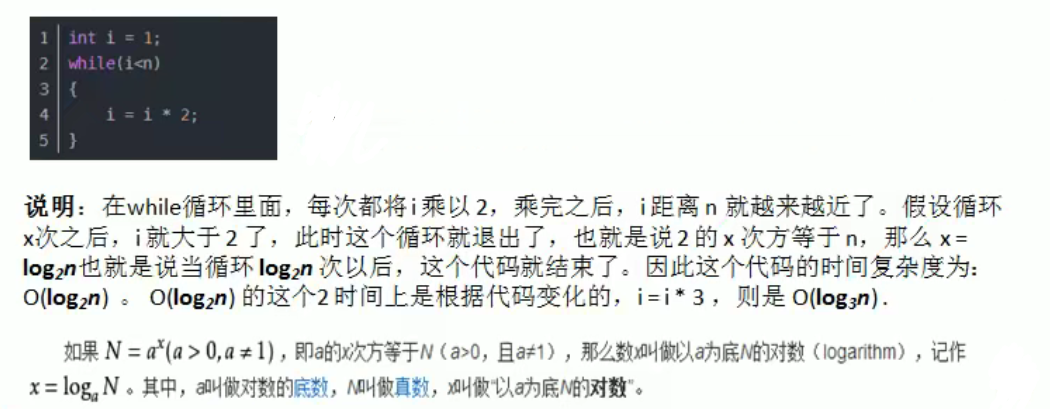
对数阶O(log2 n)
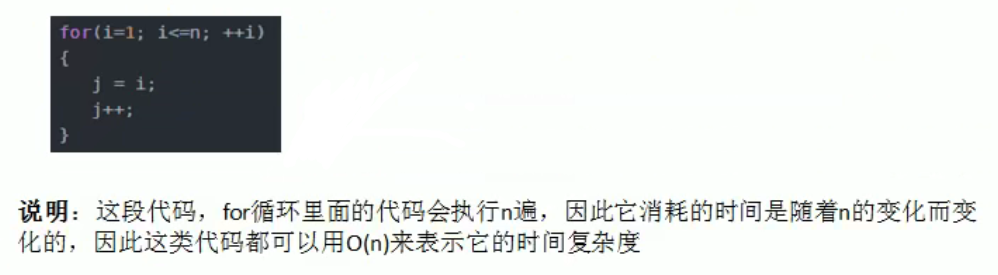
线性阶O(n)
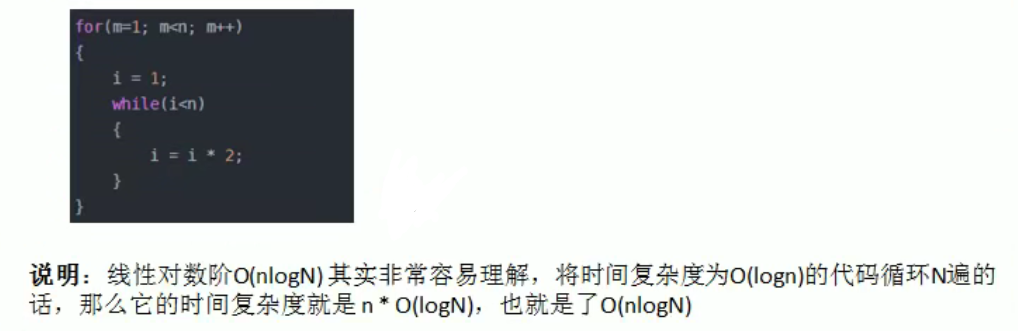
线性对数阶0(nlog2 n)
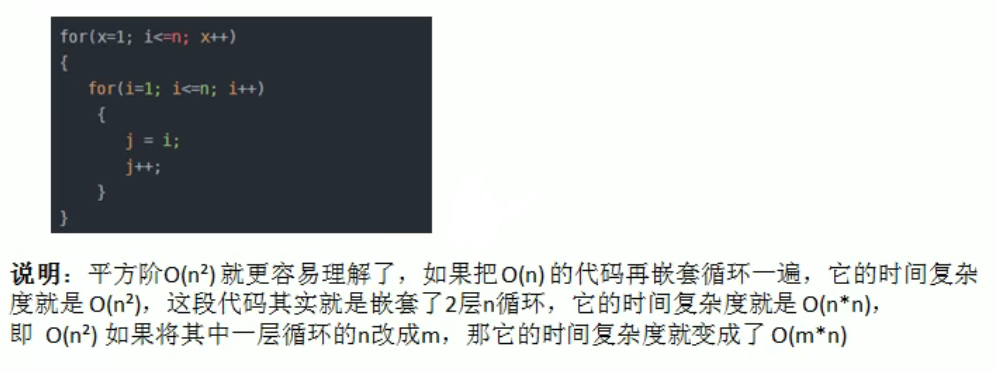
平方阶O(n2 )
立方阶O(n3 )
k次方阶O(nk )
指数阶0(2n )
时间复杂度举例 常数阶O(1)
对数阶O(log2 n)
线性阶O(n)
线性对数阶0(nlog2 n)
平方阶O(n2 )
立方阶O(n3 )、k次方阶O(nk ) 说明:参考上面的O(n2 )去理解就好了,O(n3 )相当于三层n循环,其它的类似
指数阶0(2n ) 算法的空间复杂度
类似于时间复杂度的讨论,一个算法的空间复杂度(Space Complexity)定义为该算法所耗费的存储空间,它也是间题规模n的函数。
空间复杂度(Space Complexity)是对一个 算法在运行过程中临时占用存储空间大小的量度。有的算法需要占用的临时工作单元数与解决问题的规模n有关,它随着n的增大而增大,当n较大时,将占用较多的存储单元,例如快速排序和归并排序算法就属于这种情况。
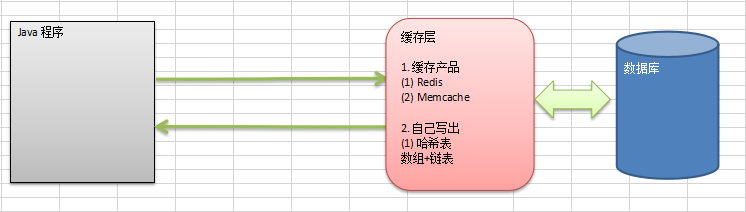
在做算法分析时,主要讨论的是时间复杂度 。从用户使用体验上看,更看重的程序执行的速度。一些缓存产品(redis, memcache)和算法(基数排序)本质就是用空间换时间。
冒泡排序 排序思想 通过对待排序序列从前向后(从下标较小的元素开始),依次比较相邻元素的值,若发现逆序则交换,使值较大的元素逐渐从前移向后部 ,就象水底下的气泡一样逐渐向上冒。
因为排序的过程中,各元素不断接近自己的位置,如果一趟比较下来没有进行过交换,就说明序列有序,因此要在排序过程中设置一个标志flag判断元素是否进行过交换 。从而减少不必要的比较。
排序规则
一共进行 数组的大小-1 次的循环
每一趟排序的次数在逐渐的减少
如果我们发现在某趟排序中,没有发生一次交换, 可以提前结束冒泡排序。
代码实现 public static void bubbleSort (int [] arr) { int temp = 0 ; boolean flag = false ; for (int i = 0 ; i < arr.length - 1 ; i++) { for (int j = 0 ; j < arr.length - 1 - i; j++) { if (arr[j] > arr[j + 1 ]) { flag = true ; temp = arr[j]; arr[j] = arr[j + 1 ]; arr[j + 1 ] = temp; } } if (!flag) { break ; } else { flag = false ; } } }
选择排序 排序思想 选择式排序也属于内部排序法,是从欲排序的数据中,按指定的规则选出某一元素,再依规定交换位置后达到排序的目的。
第一次从arr[0] 到arr[n-1]中选取最小值,与arr[0]交换,第二次从arr[1]到arr[n-1]中选取最小值,与arr[1]交换,第三次从arr[2]到arr[n-1]中选取最小值,与arr[2]交换,…,第i次从arr[i-1]到arr[n-1]中选取最小值,与arr[i-1]交换,…, 第n-1次从arr[n-2]~arr[n-1]中选取最小值,与arr[n-2]交换,总共通过n-1次,得到一个按排序码从小到大排列的有序序列。
排序规则
选择排序一共有 数组大小 -1 次的排序
每1轮排序,又是一个循环,循环的规则
先假定当前这个数是最小数
然后和后面的每个数进行比较,如果发现有比当前数更小的数,就重新确定最小数,并得到下标
当遍历到数组的最后时,就得到本轮最小数和下标
交换
代码实现 public static void selectSort (int [] arr) { for (int i = 0 ; i < arr.length - 1 ; i++) { int minIndex = i; int min = arr[i]; for (int j = i + 1 ; j < arr.length; j++) { if (min > arr[j]) { min = arr[j]; minIndex = j; } } if (minIndex != i) { arr[minIndex] = arr[i]; arr[i] = min; } } }
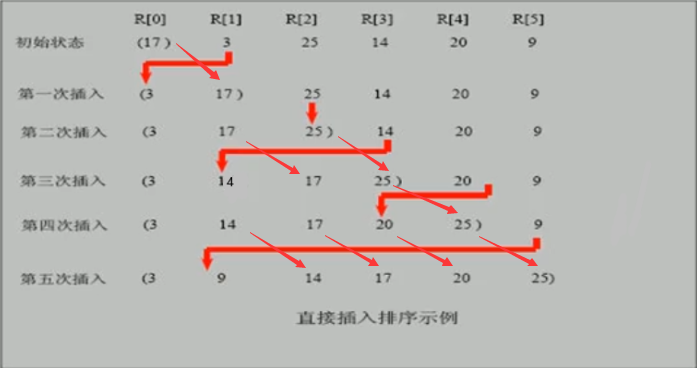
插入排序 排序思想 把n个待排序的元素看成为一个有序表和一个无序表,开始时有序表中只包含一个元素,无序表中包含有n-1个元素, 排序过程中每次从无序表中取出第一个元素,把它的排序码依次与有序表元素的排序码进行比较,将它插入到有序表中的适当位置,使之成为新的有序表。
代码实现 public static void insertSort (int [] arr) { int insertVal = 0 ; int insertIndex = 0 ; for (int i = 1 ; i < arr.length; i++) { insertVal = arr[i]; insertIndex = i - 1 ; while (insertIndex >= 0 && insertVal < arr[insertIndex]) { arr[insertIndex + 1 ] = arr[insertIndex]; insertIndex--; } if (insertIndex + 1 != i) { arr[insertIndex + 1 ] = insertVal; } } }
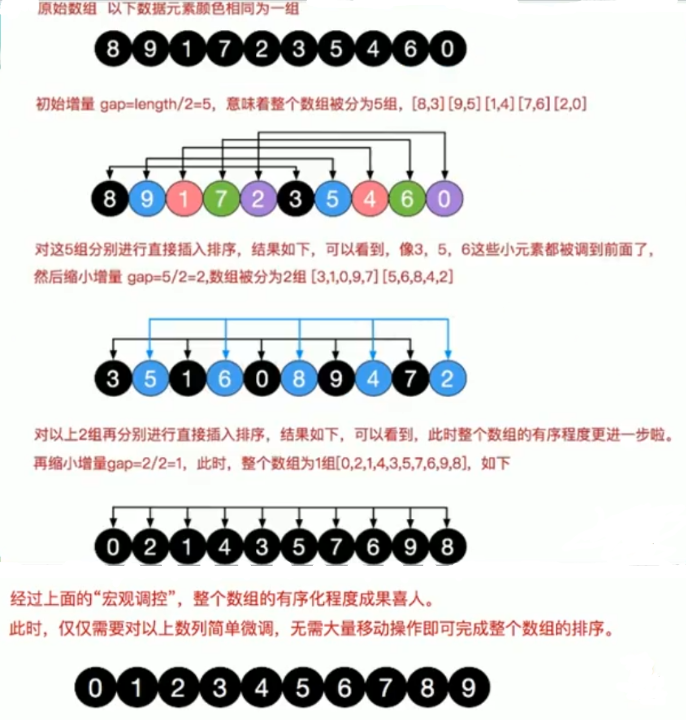
希尔排序 排序思想 希尔排序也是一种插入排序,他是简单插入排序经过改进后的一个更高效的版本,也被称为缩小增量排序 。
希尔排序是把记录按下标的一定增量分组 ,对每组使用直接插入排序算法排序 ;随着增量逐渐减少,每组包含的关键词越来越多,当增量减至1时,整个文件恰被分成一组,算法便终止
代码实现——交换法 public static void shellSort (int [] arr) { int temp = 0 ; int count = 0 ; for (int gap = arr.length / 2 ; gap > 0 ; gap /= 2 ) { for (int i = gap; i < arr.length; i++) { for (int j = i - gap; j >= 0 ; j -= gap) { if (arr[j] > arr[j + gap]) { temp = arr[j]; arr[j] = arr[j + gap]; arr[j + gap] = temp; } } } } }
代码实现——位移法(改进,引入了插入排序) public static void shellSort2 (int [] arr) { for (int gap = arr.length / 2 ; gap > 0 ; gap /= 2 ) { for (int i = gap; i < arr.length; i++) { int j = i; int temp = arr[j]; if (arr[j] < arr[j - gap]) { while (j - gap >= 0 && temp < arr[j - gap]) { arr[j] = arr[j - gap]; j -= gap; } arr[j] = temp; } } } }
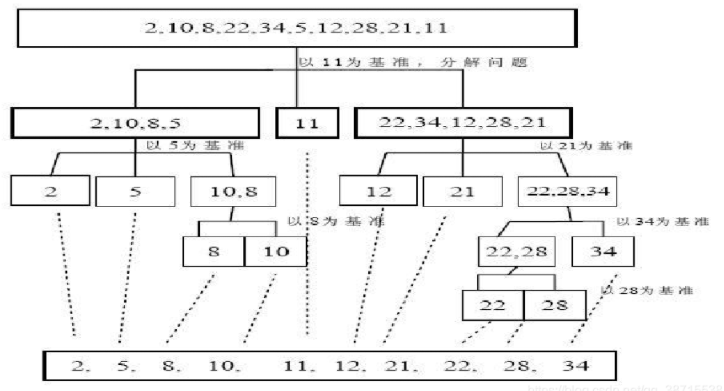
快速排序 排序思想 快速排序(Quicksort)是对冒泡排序的一种改进 。基本思想是:通过一趟排序将要排序的数据分割成独立的两部分 ,其中一部分的所有数据都比另外一部分的所有数据都要小,然后再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归 进行,以此达到整个数据变成有序序列。
排序规则
选定Pivot中心轴
将大于Pivot的数字放在Pivot的右边
将小于Pivot的数字放在Pivot的左边
分别对左右子序列重复前三步操作
代码实现1 public static void quickSort2 (int [] arr, int left, int right) { int l = left; int r = right; int pivot = arr[(left + right) / 2 ]; int temp = 0 ; while (l < r) { while (arr[l] < pivot) { l += 1 ; } while (arr[r] > pivot) { r -= 1 ; } if (l >= r) { break ; } temp = arr[l]; arr[l] = arr[r]; arr[r] = temp; if (arr[l] == pivot) { r -= 1 ; } if (arr[r] == pivot) { l += 1 ; } } if (l == r) { l += 1 ; r -= 1 ; } if (left<r){ quickSort2(arr,left,r); } if (l>right){ quickSort2(arr,l,right); } }
代码实现2 public static void quickSort (int [] arr, int start, int end) { if (start < end) { int pivot = arr[start]; int left = start; int right = end; while (left < right) { while (left < right && arr[right] >= pivot) { right--; } arr[left] = arr[right]; while (left < right && arr[left] <= pivot) { left++; } arr[right] = arr[left]; } arr[left] = pivot; quickSort(arr, start, left); quickSort(arr, left + 1 , end); } }
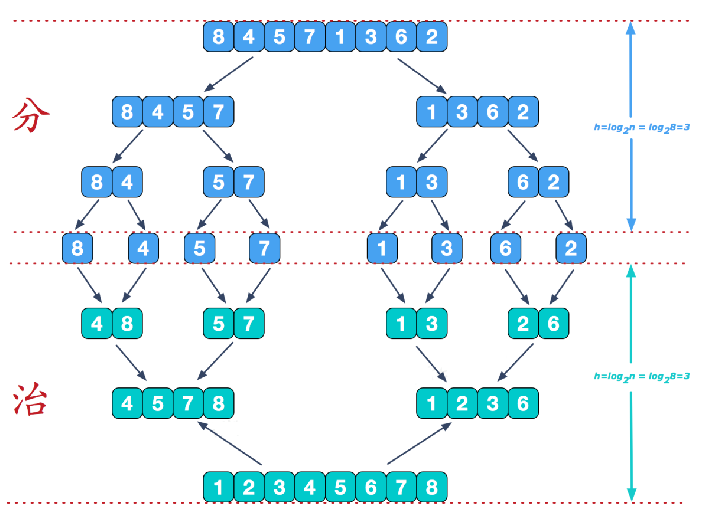
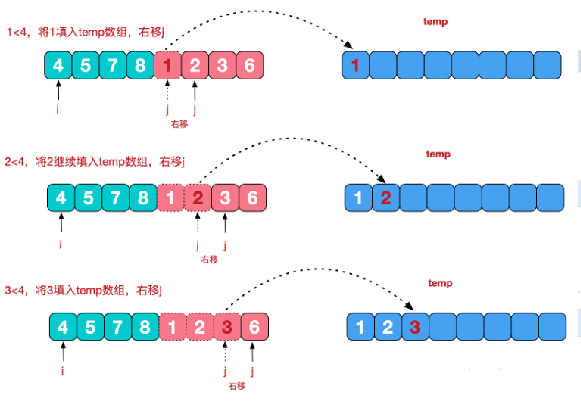
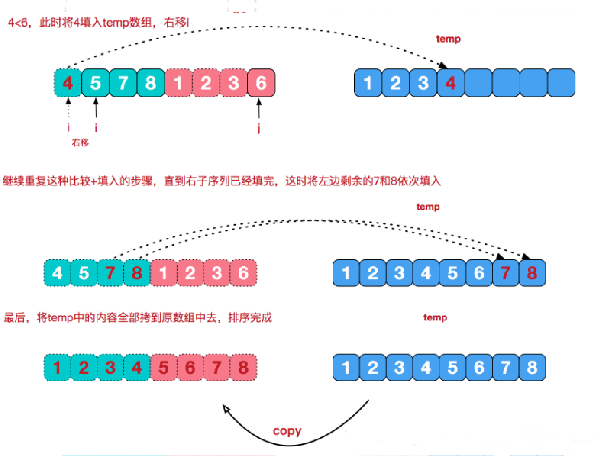
归并排序 排序思想 归并排序(MERGE-SORT)是利用归并的思想 实现的排序方法,该算法采用经典的分治(divide-and-conquer)策略 (分治法将问题==分 ==(divide)成一些小的问题然后递归求解,而==治 ==(conquer)的阶段则将分的阶段得到的各答案”修补”在一起,即分而治之)。
说明
可以看到这种结构很像一棵完全二叉树,本文的归并排序我们采用递归去实现(也可采用迭代的方式去实现)。分阶段可以理解为就是递归拆分子序列的过程。
代码实现 public static void mergeSort (int [] arr, int left, int right, int [] temp) { if (left < right) { int mid = (left + right) / 2 ; mergeSort(arr, 0 , mid, temp); mergeSort(arr, mid + 1 , right, temp); merge(arr, left, right, mid, temp); } } public static void merge (int [] arr, int left, int right, int mid, int [] temp) { int i = left; int j = mid + 1 ; int t = 0 ; while (i <= mid && j <= right) { if (arr[i] <= arr[j]) { temp[t] = arr[i]; t+=1 ; i+=1 ; } else { temp[t] = arr[j]; t+=1 ; j+=1 ; } } while (i <= mid) { temp[t] = arr[i]; t+=1 ; i+=1 ; } while (j <= right) { temp[t] = arr[j]; t+=1 ; j+=1 ; } t = 0 ; int tempLeft = left; while (tempLeft <= right) { arr[tempLeft] = temp[t]; t+=1 ; tempLeft+=1 ; } }
基数排序 排序思想 基数排序(radix sort)属于“分配式排序 ”(distribution sort),又称“桶子法 ”(bucket sort)或bin sort,顾名思义,它是通过键值的各个位的值,将要排序的元素分配 至某些“桶”中,达到排序的作用,是桶排序的扩展 。
基数排序法是属于稳定性的排序,基数排序法的是效率高的稳定性排序法。
基本思想:将所有待比较数值统一为同样的数位长度,数位较短的数前面补零。然后,从最低位开始,依次进行一次排序 。这样从最低位排序一直到最高位排序完成以后, 数列就变成一个有序序列。
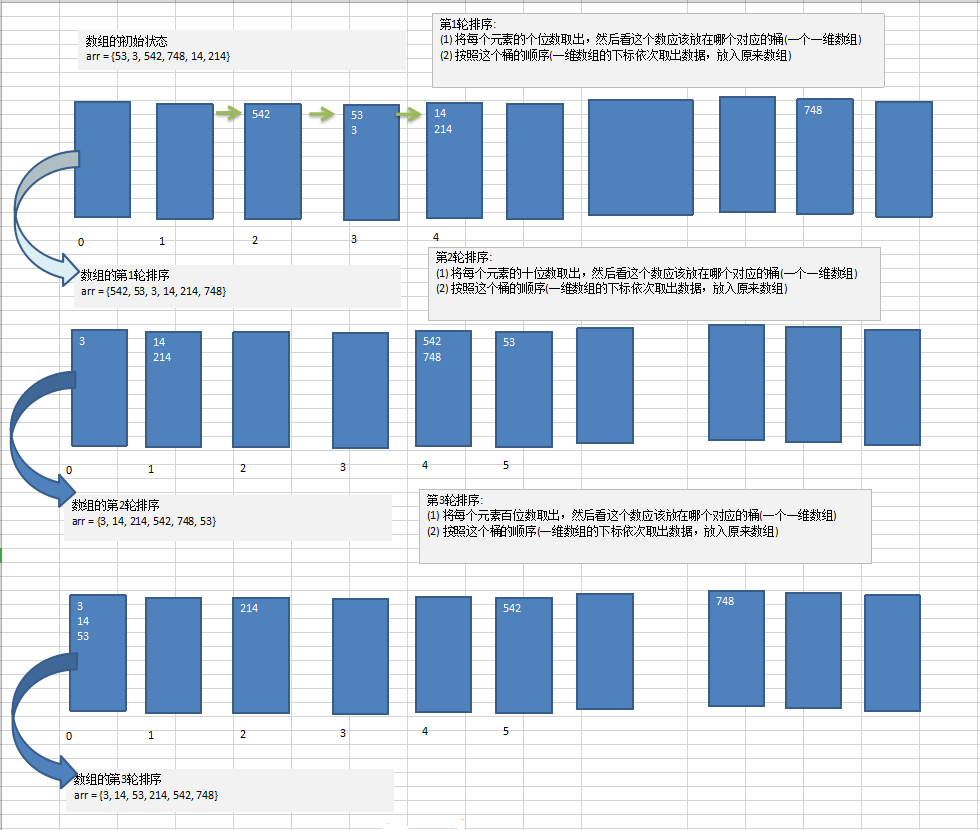
举例图示:将数组 {53, 3, 542, 748, 14, 214} 使用基数排序, 进行升序排序。
代码实现 package com.datastructures.tree.heap;import java.text.SimpleDateFormat;import java.util.ArrayList;import java.util.Arrays;import java.util.Date;public class HeapSort { public static void main (String[] args) { int [] arr=new int [800000 ]; for (int i=0 ;i<800000 ;i++){ arr[i]=(int )(Math.random()*800000 ); } Date date1 = new Date (); SimpleDateFormat simpleDateFormat = new SimpleDateFormat ("yyyy-MM-dd HH:mm:ss" ); String date1Str = simpleDateFormat.format(date1); System.out.println("排序前的时间是:" +date1Str); heapSort(arr); Date date2 = new Date (); String date2Str = simpleDateFormat.format(date2); System.out.println("排序后的时间是:" +date2Str); } public static void heapSort (int [] arr) { int temp = 0 ; for (int i = arr.length / 2 - 1 ; i >= 0 ; i--) { adjustHeap(arr, i, arr.length); } for (int j = arr.length - 1 ; j > 0 ; j--) { temp = arr[j]; arr[j] = arr[0 ]; arr[0 ] = temp; adjustHeap(arr, 0 , j); } } public static void adjustHeap (int arr[], int i, int length) { int temp = arr[i]; for (int k = i * 2 + 1 ; k < length; k = k * 2 + 1 ) { if (k + 1 < length && arr[k] < arr[k + 1 ]) { k++; } if (arr[k] > temp) { arr[i] = arr[k]; i = k; } else { break ; } } arr[i] = temp; } }
基数排序的说明
基数排序是对传统桶排序的扩展,速度很快 .
基数排序是经典的空间换时间 的方式,占用内存很大 , 当对海量数据排序时,容易造成 OutOfMemoryError 。
基数排序是稳定的。
注:假定在待排序的记录序列中,存在多个具有相同的关键字的记录,若经过排序,这些记录的相对次序保持不变 ,即在原序列中,r[i]=r[j],且r[i]在r[j]之前,而在排序后的序列中,r[i]仍在r[j]之前,则称这种排序算法是稳定的;否则称为不稳定的。
有负数的数组,一般不用基数排序来进行排序
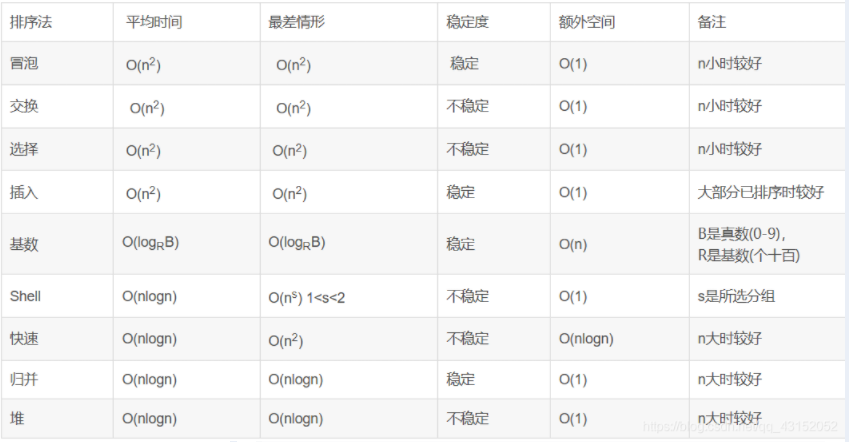
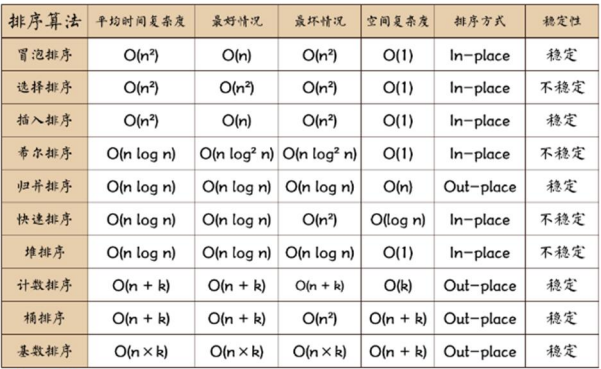
总结和对比
稳定:如果a原本在b前面,而a=b,排序之后a仍然在b的前面;
不稳定:如果a原本在b的前面,而a=b, 排序之后a可能会出现在b的后面;
内排序:所有排序操作都在内存中完成;
外排序:由于数据太大,因此把数据放在磁盘中,而排序通过磁盘和内存的数据传输才能进行;
时间复杂度:一个算法执行所耗费的时间。
空间复杂度:运行完一个程序所需内存的大小。
n:数据规模
k:“桶”的个数
In-place:不占用额外内存
Out-place:占用额外内存
查找算法 在java中,我们常用的查找有四种:
顺序(线性)查找
二分查找/折半查找
插值查找
斐波那契杏找
线性查找 代码实现 public class SeqSearch { public static void main (String[] args) { int arr[] = {1 , 9 , 11 , -1 , 34 , 89 }; int index = seqSearch(arr, 11 ); if (index == -1 ) { System.out.println("没有找到" ); } else { System.out.println("找到数字的第一个位置是" + index); } } public static int seqSearch (int [] arr, int value) { for (int i = 0 ; i < arr.length; i++) { if (arr[i] == value) { return i; } } return -1 ; } public static List<Integer> seqSearch2 (int [] arr, int value) { ArrayList<Integer> list = new ArrayList <>(); for (int i = 0 ; i < arr.length; i++) { if (arr[i] == value) { list.add(i); } } for (Integer index : list) { System.out.println("您要找的数据在数组中的下标为:" + index); } return null ; } }
二分查找 思路分析
首先确定该数组的中间的下标 mid = (left + right) / 2
然后让需要查找的数 findVal 和 arr[mid] 比较
findVal > arr[mid],说明你要查找的数在mid 的右边, 因此需要递归的向右查找
findVal < arr[mid],说明你要查找的数在mid 的左边, 因此需要递归的向左查找
findVal == arr[mid] 说明找到,就返回
什么时候我们需要结束递归.
找到就结束递归
递归完整个数组,仍然没有找到findVal ,也需要结束递归 当 left > right 就需要退出
代码实现 public class BinarySearch { public static void main (String[] args) { int arr[] = {1 , 8 , 10 , 89 , 1000 , 1234 }; int index = binarySearch(arr, 0 , arr.length - 1 , 1000 ); if (index == -1 ) { System.out.println("没有找到" ); } else { System.out.println("找到数字的第一个位置是" + index); } } public static int binarySearch (int [] arr, int left, int right, int findVal) { int mid = (left + right) / 2 ; int midVal = arr[mid]; if (left > right) { return -1 ; } if (findVal > midVal) { return binarySearch(arr, mid + 1 , right, findVal); } else if (findVal < midVal) { return binarySearch(arr, left, mid - 1 , findVal); } else { return mid; } } public static ArrayList<Integer> binarySearch2 (int [] arr, int left, int right, int findVal) { if (left > right) { return new ArrayList <Integer>(); } int mid = (left + right) / 2 ; int midVal = arr[mid]; if (findVal > midVal) { return binarySearch2(arr, mid + 1 , right, findVal); } else if (findVal < midVal) { return binarySearch2(arr, left, mid - 1 , findVal); } else { ArrayList<Integer> list = new ArrayList <>(); int temp = mid - 1 ; while (true ) { if (temp < 0 || arr[temp] != findVal) { break ; } else { list.add(temp); temp--; } } list.add(mid); temp = mid + 1 ; while (true ) { if (temp > arr.length - 1 || arr[temp] != findVal) { break ; } else { list.add(temp); temp++; } } return list; } } }
插值查找 思路分析
插值查找算法类似于二分查找,不同的是插值查找每次从自适应mid处开始查找。
将折半查找中的求mid索引的公式,low表示左边索引left,high表示右边索引right。
int midIndex = low + (high - low) * (key - arr[low])/(arr[high]-arr[low]) ;/* 插值 索引 */
举例说明插值查找算法1-100的数组
数组 arr = [1, 2, 3, ……., 100]
假如我们需要查找的值 1
使用二分查找的话,我们需要多次递归,才能找到 1
使用插值查找算法
==int mid = left + (right – left) * (findVal – arr[left]) / (arr[right] – arr[left]) ==
int mid = 0 + (99 - 0) * (1 - 1)/ (100 - 1) = 0 + 99 * 0 / 99 = 0
比如我们查找的值 100
int mid = 0 + (99 - 0) * (100 - 1) / (100 - 1) = 0 + 99 * 99 / 99 = 0 + 99 = 99
代码实现 public class InsertValueSearch { public static void main (String[] args) { int [] arr = {1 , 8 , 10 , 89 , 1000 ,1000 ,1000 , 1234 }; int index = insertValSearch(arr, 0 , arr.length-1 , 1234 ); System.out.println("index=" +index); } public static int insertValSearch (int [] arr, int left, int right, int findVal) { if (left > right || findVal < arr[0 ] || findVal > arr[arr.length - 1 ]) { return -1 ; } int mid = left + (right - left) * (findVal - arr[left]) / (arr[right] - arr[left]) ; int midVal = arr[mid]; if (findVal > midVal) { return insertValSearch(arr, mid + 1 , right, findVal); } else if (findVal < midVal) { return insertValSearch(arr, left, mid - 1 , findVal); } else { return mid; } } }
注意事项
对于数据量较大 ,关键字分布比较均匀 的查找表来说,采用插值查找,速度较快 .
关键字分布不均匀 的情况下,该方法不一定比折半查找要好。
斐波那契查找 基本介绍
黄金分割点是指把一条线段 分割为两部分,使其中一部分与全长之比等于另一部分与这部分之比。取其前三位数字的近似值是0.618 。由于按此比例设计的造型十分美丽,因此称为黄金分割 ,也称为中外比 。这是一个神奇的数字,会带来意向不大的效果。
斐波那契数列 {1,1,2,3,5,8,13,21,34,55}发现斐波那契数列的两个相邻数的比例,无限接近黄金分割值0.618。
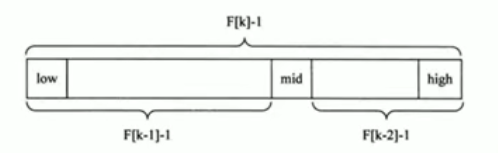
原理 斐波那契查找 原理与前两种相似,仅仅改变了中间结点(mid) 的位置,mid不再是中间或插值得到,而是位于黄金分割点附近,即mid=low+F(k-1)-1(F代表斐波那契数列),如下图所示
对F(k-1)-1的理解:
由斐波那契数列 F[k]=F[k-1]+F[k-2]的性质,可以得到**(F[k]-1) = (F[k-1]-1) + (F[k-2]-1) +1**。
该式说明:只要顺序表的长度为F[k]-1 ,则可以将该表分成长度为F[k-1]-1 和F[k-2]-1 的两段,即如上图所示。从而中间位置为mid=low+F(k-1)-1
类似的,每一子段也可以用相同的方式分割
但顺序表长度n不一定刚好等于F[k]-1,所以需要将原来的顺序表长度n增加至F[k]-1。这里的k值只要能使得F[k]-1恰好大于或等于n即可,由以下代码得到顺序表长度增加后,新增的位置(从n+1到F[k}-1位置),都赋为n位置的值即可。
代码实现 public class FibonacciSearch { public static int maxSzie = 20 ; public static void main (String[] args) { int [] arr = {1 , 8 , 10 , 89 , 1000 , 1234 }; int index = fibSearch(arr, 1234 ); System.out.println("您要找的数据的下标是:" + index); } public static int [] fib() { int [] fib = new int [maxSzie]; fib[0 ] = 1 ; fib[1 ] = 1 ; for (int i = 2 ; i < maxSzie; i++) { fib[i] = fib[i - 1 ] + fib[i - 2 ]; } return fib; } public static int fibSearch (int [] arr, int value) { int low = 0 ; int high = arr.length - 1 ; int k = 0 ; int mid; int fib[] = fib(); while (arr.length > fib[k] - 1 ) { k++; } int [] temp = Arrays.copyOf(arr, fib[k]); for (int i = high + 1 ; i < fib[k]; i++) { temp[i] = arr[high]; } while (low <= high) { mid = low + fib[k - 1 ] - 1 ; if (value < temp[mid]) { high = mid - 1 ; k--; } else if (value > temp[mid]) { low = mid + 1 ; k -= 2 ; } else { if (mid <= high) return mid; else return high; } } return -1 ; } }
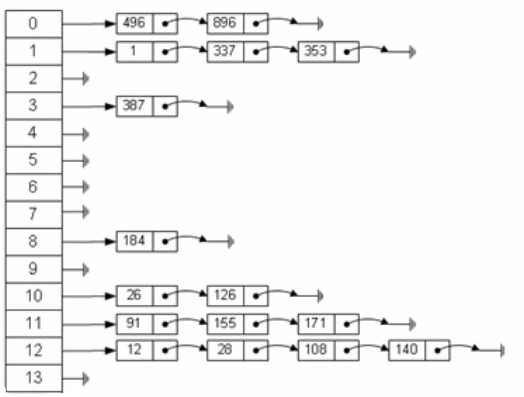
哈希表 概述 散列表(Hash table,也叫哈希表),是根据关键码值(Key value)而直接进行访问的数据结构。也就是说,它通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数,存放记录的数组叫做散列表。
散列表 (Hash table,也叫哈希表),是根据关键码值(Key value)而直接进行访问的数据结构 。也就是说,它通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数 ,存放记录的数组 叫做散列表 。
+++
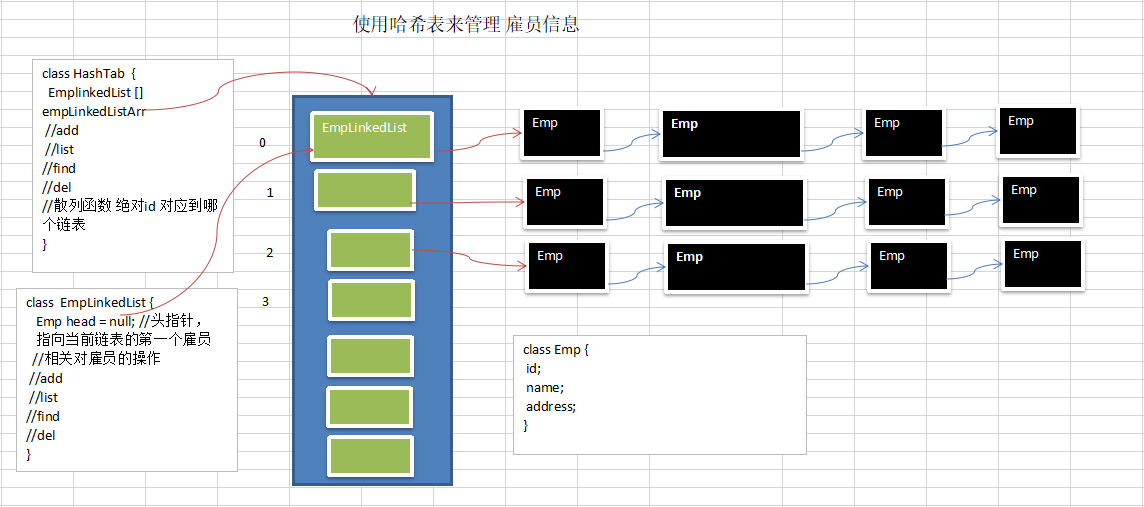
有一个公司,当有新的员工来报道时,要求将该员工的信息加入(id,性别,年龄,住址……),当输入该员工的id时,要求查找到该员工的所有信息。
要求:不使用数据库,尽量节省内存,速度越快越好=>哈希表(散列)
思路分析
代码实现 方法类
import java.util.Scanner;public class HashTableDemo { public static void main (String[] args) { HashTab hashTable = new HashTab (7 ); String key = "" ; Scanner scanner = new Scanner (System.in); while (true ){ System.out.println("add: 添加雇员" ); System.out.println("list: 显示雇员" ); System.out.println("find: 查找雇员" ); System.out.println("del: 删除雇员" ); System.out.println("exit: 退出系统" ); System.out.println("请输入相关指令:" ); key = scanner.next(); switch (key){ case "add" : System.out.print("输入id:" ); int id = scanner.nextInt(); System.out.print("输入姓名:" ); String name = scanner.next(); Emp emp = new Emp (id, name); hashTable.add(emp); break ; case "list" : hashTable.list(); break ; case "find" : System.out.print("输入员工id:" ); int no = scanner.nextInt(); hashTable.findEmpById(no); break ; case "del" : System.out.print("输入员工id:" ); int no1 = scanner.nextInt(); hashTable.deleteEmpById(no1); break ; case "exit" : scanner.close(); System.exit(0 ); default : break ; } } } }
**HashTab **
public class HashTab { private EmpLinkedList[] empLinkedList; private int size; public HashTab (int size) { this .size = size; this .empLinkedList = new EmpLinkedList [size]; for (int i = 0 ; i < size; i++) { empLinkedList[i] = new EmpLinkedList (); } } public int hashFun (int id) { return id % size; } public void add (Emp emp) { int empLinkedListNo = hashFun(emp.id); empLinkedList[empLinkedListNo].add(emp); } public void list () { for (int i = 0 ; i < size; i++) { empLinkedList[i].list(i); } } public void findEmpById (int id) { int empLinkedListNo = hashFun(id); Emp emp = empLinkedList[empLinkedListNo].findEmpById(id); if (emp == null ) { System.out.println("未找到" ); } else { System.out.println("第" + empLinkedListNo + "条链表中,id为" + emp.id + "雇员的信息" + emp); } } public void deleteEmpById (int id) { int empLinkedListNo = hashFun(id); boolean flag = empLinkedList[empLinkedListNo].deleteById(id); if (!flag) { System.out.println("未找到" ); } else { System.out.println("第" + empLinkedListNo + "条链表中的雇员的信息已删除" ); } } }
EmpLinkedList
public class EmpLinkedList { public Emp head; public void add (Emp emp) { if (head == null ) { head = emp; return ; } Emp curEmp = head; if (curEmp.id > emp.id) { emp.next = head; head = emp; return ; } while (true ) { if (curEmp.next == null ) { break ; } if (curEmp.next.id > emp.id) { break ; } curEmp = curEmp.next; } emp.next = curEmp.next; curEmp.next = emp; } public void list (int no) { if (head == null ) { System.out.println("第" + no + "条链表为空" ); return ; } System.out.println("第" + no + "条链表:" ); Emp curEmp = head; while (true ) { System.out.println(curEmp); if (curEmp.next == null ) { break ; } curEmp = curEmp.next; } } public Emp findEmpById (int id) { if (head == null ) { System.out.println("链表为空" ); return null ; } Emp curEmp = head; while (true ) { if (curEmp.id == id) { break ; } if (curEmp.next == null ) { curEmp = null ; break ; } curEmp = curEmp.next; } return curEmp; } public boolean deleteById (int id) { if (head == null ) { System.out.println("链表为空" ); return false ; } if (head.id == id) { head = head.next; return true ; } Emp curEmp = head; while (true ) { if (curEmp.next == null ) { break ; } if (curEmp.next.id == id) { if (curEmp.next.next == null ) { curEmp.next = null ; } else { curEmp.next = curEmp.next.next; } break ; } curEmp = curEmp.next; } return false ; } }
Emp
public class Emp { public int id; public String name; public Emp next; public Emp (int id, String name) { super (); this .id = id; this .name = name; } @Override public String toString () { return "Emp{" + "id=" + id + ", name='" + name + '\'' + '}' ; } }
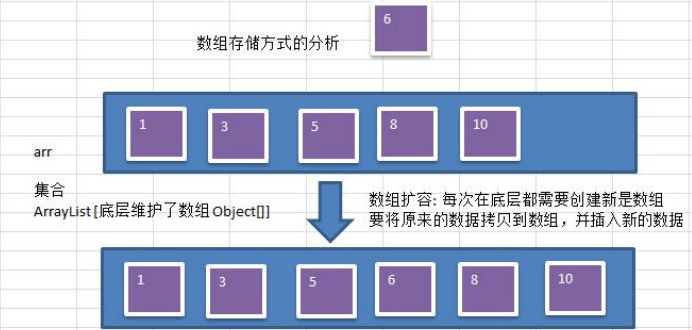
树结构 概述 数组存储方式的分析 优点 :通过下标方式访问元素 ,速度快。对于有序数组,还可使用二分查找 提高检索速度。
缺点 :如果要检索具体某个值,或者插入值(按一定顺序)会整体移动 , 效率较低
操作示意图:
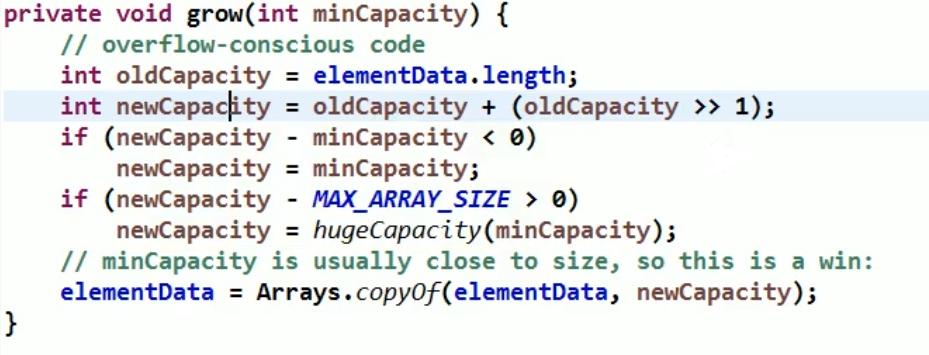
ArrayList集合的扩容 ArrayList底层仍然是数组扩容,利用grow方式进行扩容
ArrayList中维护了一个Object类型的数组elementData。 [debug看源码] 当创建对象时,如果使用的是无参构造器,则初始elementData容量为0 (jdk7 是10) 如果使用的是指定容量capacity的构造器,则初始elementData容量为 capacity。 当添加元素时:先判断是否需要扩容,如果需要扩容,则调用grow方法,否则直接添加元素到合适位置 如果使用的是无参构造器,如果第一次添加, 需要扩容的话,则扩容elementData为10,如果需要再次扩容的话,则扩容elementData为1.5倍。 如果使用的是指定容量capacity的构造器,如果需要扩容,则直接扩容elementData为1.5倍。
链式存储方式的分析 优点 :在一定程度上对数组存储方式有优化(比如:插入 一个数值节点,只需要将插入节点,链接到链表中即可,删除 效率也很好)。
缺点 :在进行检索时 ,效率仍然较低,比如(检索某个值,需要从头节点开始遍历)
操作示意图:
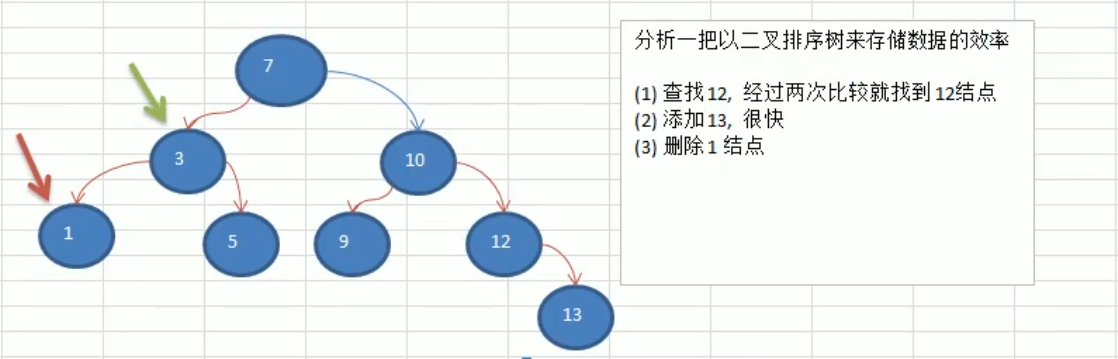
树存储方式的分析 能提高数据存储,读取 的效率,比如利用 二叉排序树(Binary Sort Tree),既可以保证数据的检索速度,同时也可以保证数据的插入,删除,修改的速度。
案例: [7, 3, 10, 1, 5, 9, 12]
基础部分 二叉树 概述
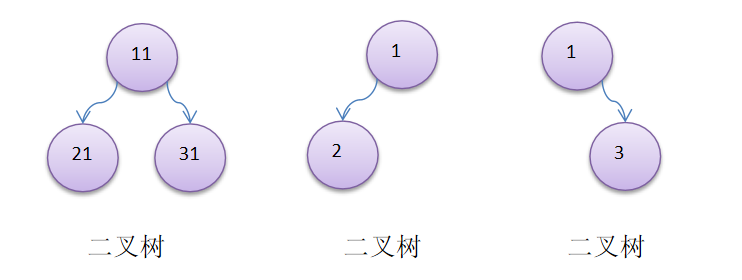
树有很多种,每个节点最多只能有两个子节点的一种形式称为二叉树。
二叉树的子节点分为左节点和右节点。
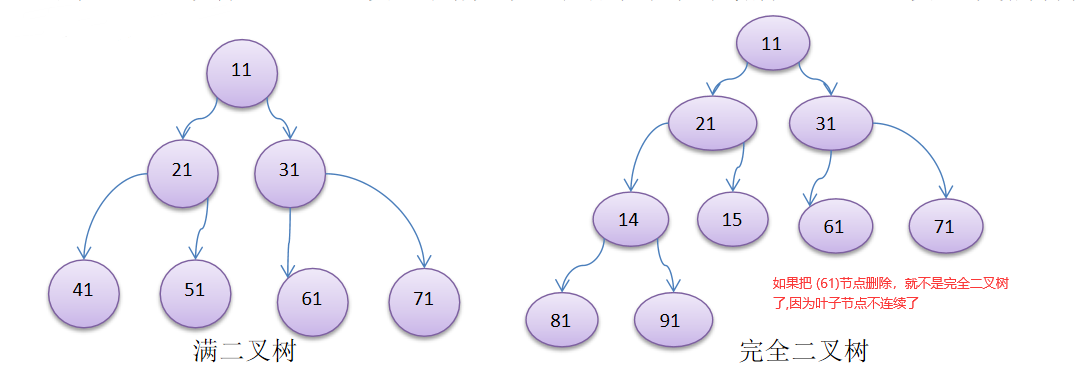
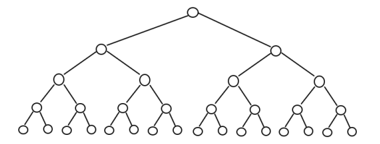
如果该二叉树的所有叶子节点都在最后一层,并且结点总数= 2^n -1 , n 为层数,则我们称为满二叉树。
如果该二叉树的所有叶子节点都在最后一层或者倒数第二层,而且最后一层的叶子节点在左边连续,倒数第二层的叶子节点在右边连续,我们称为完全二叉树。
二叉树的遍历 前序遍历:先输出父节点 ,再遍历左子树和右子树
中序遍历:先遍历左子树,再输出父节点 ,再遍历右子树
后序遍历:先遍历左子树,再遍历右子树,最后输出父节点
小结: 看输出父节点的顺序,就确定是前序,中序还是后序
思路分析 分析二叉树的前序,中序,后序的遍历步骤
创建一颗二叉树
前序遍历(中、左、右)
先输出当前节点(初始的时候是root节点);
如果左子节点不为空,则递归继续前序遍历;
如果右子节点不为空,则递归继续前序遍历。
中序遍历(左、中、右)
如果当前节点的左子节点不为空,则递归中序遍历;
输出当前节点;
如果当前节点的右子节点不为空,则递归中序遍历。
后序遍历(左、右、中)
如果当前节点的左子节点不为空,则递归后序遍历;
如果当前节点的右子节点不为空,则递归后序遍历;
输出当前节点。
核心代码实现 public void preOrder () { System.out.println(this ); if (this .left != null ) { this .left.preOrder(); } if (this .right != null ) { this .right.preOrder(); } } public void infixOrder () { if (this .left != null ) { this .left.infixOrder(); } System.out.println(this ); if (this .right != null ) { this .right.infixOrder(); } } public void postOrder () { if (this .left != null ) { this .left.postOrder(); } if (this .right != null ) { this .right.postOrder(); } System.out.println(this ); }
二叉树的查找
请编写前序查找,中序查找和后序查找的方法。
并分别使用三种查找方式,查找 heroNO = 5 的节点
并分析各种查找方式,分别比较了多少次
思路分析 使用前序、中序、后序的方式来查询指定的节点
前序查找思路
先判断当前id是否等于要查找的id
如果是相等,则返回当前节点
如果不等,则判断当前节点的左子节点是否为空,如果不为空,则递归前序查找
如果左递归前序查找,找到了,则返回;否则继续判断,当前节点的右子节点是否为空,如果不为空,则继续向右递归前序查找
中序查找思路
先判断当前节点的左子节点是否为空,如果不为空,则递归中序查找
如果如果找到,就返回,如果没有找到,就和当前节点进行比较,如果是(找到)则返回当前节点,否则继续进行右递归的中序查找。
如果右递归中序查找,找到了就返回,找不到就返回null
后序查找思路
先判断当前的左子节点是否为空,如果不为空,则递归后序查找
如果找到就返回,如果没有找到就判断当前节点的右子节点是否为空,如果不为空,则右递归进行后序查找,如果找到,就返回
如果没有找到,就和当前节点进行比较,如果是(找到)就返回,否则返回null
核心代码实现 public HeroNode preOrderSearch (int no) { System.out.println("进入前序遍历查找的方式" ); if (this .no == no) { return this ; } HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.preOrderSearch(no); } if (resNode != null ) { return resNode; } if (this .right != null ) { resNode = this .right.preOrderSearch(no); } return resNode; } public HeroNode infixOrderSearch (int no) { HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.infixOrderSearch(no); } if (resNode != null ) { return resNode; } System.out.println("进入中序遍历查找" ); if (this .no == no) { return this ; } if (this .right != null ) { resNode = this .right.infixOrderSearch(no); } return resNode; } public HeroNode postOrderSearch (int no) { HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.postOrderSearch(no); } if (resNode != null ) { return resNode; } if (this .right != null ) { resNode = this .right.postOrderSearch(no); } if (resNode != null ) { return resNode; } System.out.println("进入后序查找" ); if (this .no == no) { return this ; } return resNode; }
二叉树的删除
如果删除的节点是叶子节点,则删除该节点
如果删除的节点是非叶子节点,则删除该子树.
测试,删除掉 5号叶子节点 和 3号子树.
思路分析
如果删除的节点是叶子节点,则删除该节点 如果删除的节点是非叶子节点,则删除该子树
+++
考虑如果树是空树root,如果只有一个root节点,则等价将二叉树置空。 因为我们的二叉树是单向的,所以我们是判断当前节点的子节点是否是需要删除的节点;而不是去判断当前这个节点是不是需要删除的节点。 (也就是说,如果指针指向5号,就删除不了5号,只能删除其左右子节点,找不到5号的父节点)如果当前节点的左子节点 不为空,并且左子节点的编号就是要删除的节点,那么就直接,将this.left=null,直接置空即可。并且就返回(结束递归删除)
如果当前节点的右子节点 不为空,并且右子节点就是要删除的节点,那么直接将右边置空即可,this.right=null,并且就返回(结束递归删除)
如果第2步和第3步,都没有删除节点,那么我们就需要向左子树进行递归删除。(当然也得判断左子树是否为null空)
如果第4步也没有删除节点,则应当向右子树进行递归删除。
核心代码实现 调用方法:考虑如果树是空树root,如果只有一个root节点,则等价将二叉树置空。
public void delNode (int no) { if (root != null ) { if (root.getNo() == no) { root = null ; } else { root.delNode(no); } } else { System.out.println("空树,不能删除~~" ); } }
核心代码:2、3、4、5、6
public void delNode (int no) { if (this .left != null && this .left.no == no) { this .left = null ; return ; } if (this .right != null && this .right.no == no) { this .right = null ; return ; } if (this .left != null ) { this .left.delNode(no); } if (this .right != null ) { this .right.delNode(no); } }
完整代码 public class BinaryTreeDemo01 { public static void main (String[] args) { BinaryTree binaryTree = new BinaryTree (); HeroNode root = new HeroNode (1 , "老大" ); HeroNode node2 = new HeroNode (2 , "老二" ); HeroNode node3 = new HeroNode (3 , "老三" ); HeroNode node4 = new HeroNode (4 , "老四" ); HeroNode node5 = new HeroNode (5 , "老五" ); root.setLeft(node2); root.setRight(node3); node3.setRight(node4); node3.setLeft(node5); binaryTree.setRoot(root); System.out.println("前序遍历" ); binaryTree.preOrder(); System.out.println("中序遍历" ); binaryTree.infixOrder(); System.out.println("后序遍历" ); binaryTree.postOrder(); System.out.println("前序遍历查找的方式~~" ); HeroNode resNode = binaryTree.preOrderSearch(5 ); if (resNode != null ) { System.out.printf("找到了,信息为id=%d name=%s\n" , resNode.getNo(), resNode.getName()); } else { System.out.printf("没有找到id=%d的英雄" , 5 ); } System.out.println("中序遍历查找的方式~~" ); HeroNode resNode1 = binaryTree.infixOrderSearch(5 ); if (resNode1 != null ) { System.out.printf("找到了,信息为id=%d name=%s" , resNode1.getNo(), resNode1.getName()); } else { System.out.printf("没有找到id=%d的英雄" , 5 ); } System.out.println("后序遍历查找的方式~~" ); HeroNode resNode2 = binaryTree.postOrderSearch(5 ); if (resNode2 != null ) { System.out.printf("找到了,信息为id=%d name=%s" , resNode2.getNo(), resNode2.getName()); } else { System.out.printf("没有找到id=%d的英雄" , 5 ); } System.out.println("删除前,前序遍历的操作" ); binaryTree.preOrder(); binaryTree.delNode(5 ); System.out.println("删除后,前序遍历的操作" ); binaryTree.preOrder(); } } class BinaryTree { private HeroNode root; public void setRoot (HeroNode root) { this .root = root; } public void preOrder () { if (this .root != null ) { this .root.preOrder(); } else { System.out.println("当前二叉树为空,无法遍历" ); } } public void infixOrder () { if (this .root != null ) { this .root.infixOrder(); } else { System.out.println("当前二叉树为空,无法遍历" ); } } public void postOrder () { if (this .root != null ) { this .root.postOrder(); } else { System.out.println("当前二叉树为空,无法遍历" ); } } public HeroNode preOrderSearch (int no) { if (root != null ) { return root.preOrderSearch(no); } else { return null ; } } public HeroNode infixOrderSearch (int no) { if (root != null ) { return root.infixOrderSearch(no); } else { return null ; } } public HeroNode postOrderSearch (int no) { if (root != null ) { return root.postOrderSearch(no); } else { return null ; } } public void delNode (int no) { if (root != null ) { if (root.getNo() == no) { root = null ; } else { root.delNode(no); } } else { System.out.println("空树,不能删除~~" ); } } } class HeroNode { private int no; private String name; private HeroNode left; private HeroNode right; public HeroNode (int no, String name) { this .no = no; this .name = name; } public void setNo (int no) { this .no = no; } public void setName (String name) { this .name = name; } public void setLeft (HeroNode left) { this .left = left; } public void setRight (HeroNode right) { this .right = right; } public int getNo () { return no; } public String getName () { return name; } public HeroNode getLeft () { return left; } public HeroNode getRight () { return right; } @Override public String toString () { return "HeroNode{" + "no=" + no + ", name='" + name + '\'' + '}' ; } public void preOrder () { System.out.println(this ); if (this .left != null ) { this .left.preOrder(); } if (this .right != null ) { this .right.preOrder(); } } public void infixOrder () { if (this .left != null ) { this .left.infixOrder(); } System.out.println(this ); if (this .right != null ) { this .right.infixOrder(); } } public void postOrder () { if (this .left != null ) { this .left.postOrder(); } if (this .right != null ) { this .right.postOrder(); } System.out.println(this ); } public HeroNode preOrderSearch (int no) { System.out.println("进入前序遍历查找的方式" ); if (this .no == no) { return this ; } HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.preOrderSearch(no); } if (resNode != null ) { return resNode; } if (this .right != null ) { resNode = this .right.preOrderSearch(no); } return resNode; } public HeroNode infixOrderSearch (int no) { HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.infixOrderSearch(no); } if (resNode != null ) { return resNode; } System.out.println("进入中序遍历查找" ); if (this .no == no) { return this ; } if (this .right != null ) { resNode = this .right.infixOrderSearch(no); } return resNode; } public HeroNode postOrderSearch (int no) { HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.postOrderSearch(no); } if (resNode != null ) { return resNode; } if (this .right != null ) { resNode = this .right.postOrderSearch(no); } if (resNode != null ) { return resNode; } System.out.println("进入后序查找" ); if (this .no == no) { return this ; } return resNode; } public void delNode (int no) { if (this .left != null && this .left.no == no) { this .left = null ; return ; } if (this .right != null && this .right.no == no) { this .right = null ; return ; } if (this .left != null ) { this .left.delNode(no); } if (this .right != null ) { this .right.delNode(no); } } }
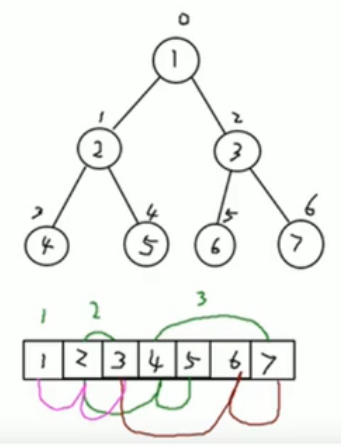
顺序存储二叉树 从数据存储来看,数组存储方式和树的存储方式可以相互转换,即数组可以转换成树,树也可以转换成数组,看右面的示意图。
右图的二叉树的结点,要求以数组的方式来存放arr:[1,2,3,4,5,6,7]
要求在遍历数组arr时,仍然可以以前序遍历,中序遍历和后序遍历的方式完成结点的遍历
思路分析 顺序存储二叉树的特点:
顺序二叉树通常只考虑完全二叉树
第n个元素的左子节点为 2*n+1
注意:这个n指的是原数组的下标,数组是从0开始的
所以,这个也是从0开始的,这个计算的左子节点也是对应元素在数组中的下标。特别注意
第n个元素的右子节点为 2*n+2
第n个元素的父节点为 (n-1)/2
n:表示二叉树中的第几个元素(按0开始编号如图所示)
代码实现 public class ArrBinaryTreeDemo { public static void main (String[] args) { int [] arr = new int []{1 , 2 , 3 , 4 , 5 , 6 , 7 }; ArrBinaryTree arrBinaryTree = new ArrBinaryTree (arr); System.out.println("前序遍历的操作" ); arrBinaryTree.preOrder(); System.out.println("中序遍历的操作" ); arrBinaryTree.midOrder(); System.out.println("后序遍历的操作" ); arrBinaryTree.postOrder(); } } class ArrBinaryTree { private int [] arr; public ArrBinaryTree (int [] arr) { this .arr = arr; } public void preOrder () { this .preOrder(0 ); } public void preOrder (int index) { if (arr == null || arr.length == 0 ) { System.out.println("数组为空,不能按照二叉树的前序进行遍历" ); } System.out.println(arr[index]); if ((index * 2 + 1 ) < arr.length) { preOrder(2 * index + 1 ); } if ((index * 2 + 2 ) < arr.length) { preOrder(2 * index + 2 ); } } public void midOrder () { midOrder(0 ); } public void midOrder (int index) { if (arr == null || arr.length == 0 ) { System.out.println("数组为空,不能进行二叉树中序遍历操作" ); } if ((2 * index + 1 ) < arr.length) { midOrder(2 * index + 1 ); } System.out.println(arr[index]); if ((2 * index + 2 ) < arr.length) { midOrder(2 * index + 2 ); } } public void postOrder () { postOrder(0 ); } public void postOrder (int index) { if (arr == null || arr.length == 0 ) { System.out.println("数组为空,不能进行二叉树后序遍历操作" ); } if ((2 * index + 1 ) < arr.length) { postOrder(2 * index + 1 ); } if ((2 * index + 2 ) < arr.length) { postOrder(2 * index + 2 ); } System.out.println(arr[index]); } }
线索化二叉树
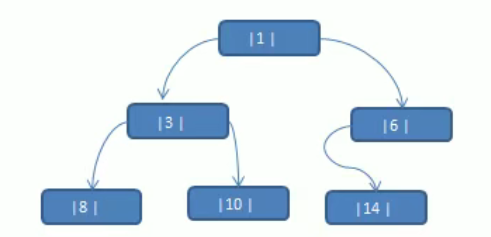
当我们对上面的二叉树进行中序遍历时,数列为 {8, 3, 10, 1, 14, 6 }
但是 6, 8, 10, 14 这几个节点的 左右指针,并没有完全的利用上.
如果我们希望充分的利用 各个节点的左右指针, 让各个节点可以指向自己的前后节点。怎么办?
解决方案——线索二叉树
概述
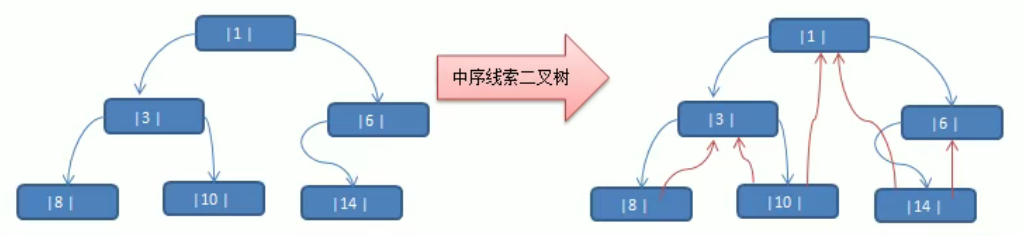
n个结点的二叉链表中含有n+1 【公式 2n-(n-1)=n+1】 个空指针域。利用二叉链表中的空指针域,存放指向该结点 在某种遍历次序 下的前驱和后继结点的指针(这种附加的指针称为”线索”);
这种加上了线索的二叉链表称为线索链表 ,相应的二叉树称为线索二叉树(Threaded BinaryTree)。根据线索性质的不同,线索二叉树可分为 前序线索二叉树、中序线索二叉树 和后序线索二叉树 三种;
一个结点的前一个结点,称为前驱 结点;
一个结点的后一个结点,称为后继 结点。
实例 应用案例说明:将下面的二叉树,进行中序线索二叉树。
中序遍历的数列为 {8, 3, 10, 1, 14, 6}
前序遍历的数列为{1, 3, 8, 10, 6, 14}
后续遍历的数列为{8, 10, 3, 14, 6, 1}
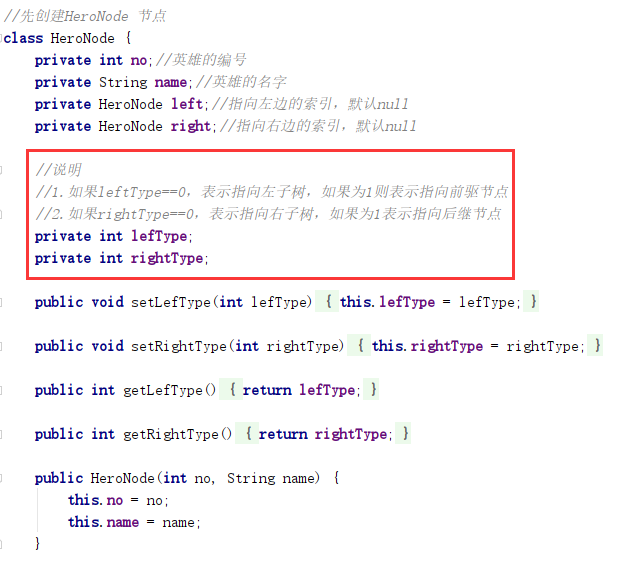
思路分析 当线索化二叉树后,Node节点的 属性 left 和 right ,有如下情况:
left 指向的是左子树 ,也可能是指向的前驱节点 。
比如 ① 节点 left 指向的左子树, 而 ⑩ 节点的 left 指向的就是前驱节点。
right指向的是右子树 ,也可能是指向的后继节点 。
比如 ① 节点 right 指向的是右子树,而⑩ 节点的 right 指向的是后继节点。
代码实现
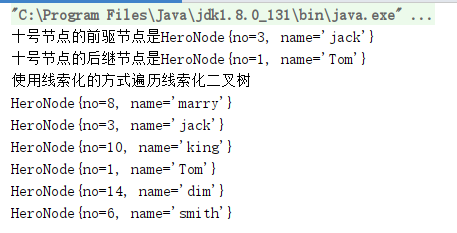
public class ThreadeBinaryTreeDemo { public static void main (String[] args) { HeroNode root = new HeroNode (1 , "Tom" ); HeroNode node2 = new HeroNode (3 , "jack" ); HeroNode node3 = new HeroNode (6 , "smith" ); HeroNode node4 = new HeroNode (8 , "marry" ); HeroNode node5 = new HeroNode (10 , "king" ); HeroNode node6 = new HeroNode (14 , "dim" ); root.setLeft(node2); root.setRight(node3); node2.setLeft(node4); node2.setRight(node5); node3.setLeft(node6); ThreadBinaryTree threadBinaryTree = new ThreadBinaryTree (); threadBinaryTree.setRoot(root); threadBinaryTree.threadNodes(); HeroNode leftNode = node5.getLeft(); System.out.println("十号节点的前驱节点是" + leftNode); System.out.println("十号节点的后继节点是" + node5.getRight()); } }
class ThreadBinaryTree { private HeroNode root; private HeroNode pre = null ; public void setRoot (HeroNode root) { this .root = root; } public void threadNodes () { this .threadeNodes(root); } public void threadeNodes (HeroNode node) { if (node == null ) { return ; } threadeNodes(node.getLeft()); if (node.getLeft() == null ) { node.setLeft(pre); node.setLefType(1 ); } if (pre != null && pre.getRight() == null ) { pre.setRight(node); pre.setRightType(1 ); } pre = node; threadeNodes(node.getRight()); } }
遍历线索化二叉树 说明
对前面的中序线索化的二叉树, 进行遍历
分析
因为线索化后,各个结点指向有变化,因此原来的遍历方式不能使用 ,这时需要使用新的方式遍历线索化二叉树,各个节点可以通过线型方式遍历,因此无需使用递归方式,这样也提高了遍历的效率。 遍历的次序应当和中序遍历保持一致 。
核心代码
public void threadList () { HeroNode node = root; while (node != null ) { while (node.getLefType() == 0 ) { node = node.getLeft(); } System.out.println(node); while (node.getRightType() == 1 ) { node = node.getRight(); System.out.println(node); } node = node.getRight(); } }
public class ThreadeBinaryTreeDemo { public static void main (String[] args) { HeroNode root = new HeroNode (1 , "Tom" ); HeroNode node2 = new HeroNode (3 , "jack" ); HeroNode node3 = new HeroNode (6 , "smith" ); HeroNode node4 = new HeroNode (8 , "marry" ); HeroNode node5 = new HeroNode (10 , "king" ); HeroNode node6 = new HeroNode (14 , "dim" ); root.setLeft(node2); root.setRight(node3); node2.setLeft(node4); node2.setRight(node5); node3.setLeft(node6); ThreadBinaryTree threadBinaryTree = new ThreadBinaryTree (); threadBinaryTree.setRoot(root); threadBinaryTree.threadNodes(); System.out.println("使用线索化的方式遍历线索化二叉树" ); threadBinaryTree.threadList(); } }
运行结果
完整代码 public class ThreadeBinaryTreeDemo { public static void main (String[] args) { HeroNode root = new HeroNode (1 , "Tom" ); HeroNode node2 = new HeroNode (3 , "jack" ); HeroNode node3 = new HeroNode (6 , "smith" ); HeroNode node4 = new HeroNode (8 , "marry" ); HeroNode node5 = new HeroNode (10 , "king" ); HeroNode node6 = new HeroNode (14 , "dim" ); root.setLeft(node2); root.setRight(node3); node2.setLeft(node4); node2.setRight(node5); node3.setLeft(node6); ThreadBinaryTree threadBinaryTree = new ThreadBinaryTree (); threadBinaryTree.setRoot(root); threadBinaryTree.threadNodes(); HeroNode leftNode = node5.getLeft(); System.out.println("十号节点的前驱节点是" + leftNode); System.out.println("十号节点的后继节点是" + node5.getRight()); System.out.println("使用线索化的方式遍历线索化二叉树" ); threadBinaryTree.threadList(); } } class ThreadBinaryTree { private HeroNode root; private HeroNode pre = null ; public void setRoot (HeroNode root) { this .root = root; } public void threadNodes () { this .threadeNodes(root); } public void threadList () { HeroNode node = root; while (node != null ) { while (node.getLefType() == 0 ) { node = node.getLeft(); } System.out.println(node); while (node.getRightType() == 1 ) { node = node.getRight(); System.out.println(node); } node = node.getRight(); } } public void threadeNodes (HeroNode node) { if (node == null ) { return ; } threadeNodes(node.getLeft()); if (node.getLeft() == null ) { node.setLeft(pre); node.setLefType(1 ); } if (pre != null && pre.getRight() == null ) { pre.setRight(node); pre.setRightType(1 ); } pre = node; threadeNodes(node.getRight()); } public void preOrder () { if (this .root != null ) { this .root.preOrder(); } else { System.out.println("当前二叉树为空,无法遍历" ); } } public void infixOrder () { if (this .root != null ) { this .root.infixOrder(); } else { System.out.println("当前二叉树为空,无法遍历" ); } } public void postOrder () { if (this .root != null ) { this .root.postOrder(); } else { System.out.println("当前二叉树为空,无法遍历" ); } } public HeroNode preOrderSearch (int no) { if (root != null ) { return root.preOrderSearch(no); } else { return null ; } } public HeroNode infixOrderSearch (int no) { if (root != null ) { return root.infixOrderSearch(no); } else { return null ; } } public HeroNode postOrderSearch (int no) { if (root != null ) { return root.postOrderSearch(no); } else { return null ; } } public void delNode (int no) { if (root != null ) { if (root.getNo() == no) { root = null ; } else { root.delNode(no); } } else { System.out.println("空树,不能删除~~" ); } } } class HeroNode { private int no; private String name; private HeroNode left; private HeroNode right; private int lefType; private int rightType; public void setLefType (int lefType) { this .lefType = lefType; } public void setRightType (int rightType) { this .rightType = rightType; } public int getLefType () { return lefType; } public int getRightType () { return rightType; } public HeroNode (int no, String name) { this .no = no; this .name = name; } public void setNo (int no) { this .no = no; } public void setName (String name) { this .name = name; } public void setLeft (HeroNode left) { this .left = left; } public void setRight (HeroNode right) { this .right = right; } public int getNo () { return no; } public String getName () { return name; } public HeroNode getLeft () { return left; } public HeroNode getRight () { return right; } @Override public String toString () { return "HeroNode{" + "no=" + no + ", name='" + name + '\'' + '}' ; } public void preOrder () { System.out.println(this ); if (this .left != null ) { this .left.preOrder(); } if (this .right != null ) { this .right.preOrder(); } } public void infixOrder () { if (this .left != null ) { this .left.infixOrder(); } System.out.println(this ); if (this .right != null ) { this .right.infixOrder(); } } public void postOrder () { if (this .left != null ) { this .left.postOrder(); } if (this .right != null ) { this .right.postOrder(); } System.out.println(this ); } public HeroNode preOrderSearch (int no) { System.out.println("进入前序遍历查找的方式" ); if (this .no == no) { return this ; } HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.preOrderSearch(no); } if (resNode != null ) { return resNode; } if (this .right != null ) { resNode = this .right.preOrderSearch(no); } return resNode; } public HeroNode infixOrderSearch (int no) { HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.infixOrderSearch(no); } if (resNode != null ) { return resNode; } System.out.println("进入zhong序遍历查找" ); if (this .no == no) { return this ; } if (this .right != null ) { resNode = this .right.infixOrderSearch(no); } return resNode; } public HeroNode postOrderSearch (int no) { HeroNode resNode = null ; if (this .left != null ) { resNode = this .left.postOrderSearch(no); } if (resNode != null ) { return resNode; } if (this .right != null ) { resNode = this .right.postOrderSearch(no); } if (resNode != null ) { return resNode; } System.out.println("进入后序查找" ); if (this .no == no) { return this ; } return resNode; } public void delNode (int no) { if (this .left != null && this .left.no == no) { this .left = null ; return ; } if (this .right != null && this .right.no == no) { this .right = null ; return ; } if (this .java != null ) { this .left.delNode(no); } if (this .right != null ) { this .right.delNode(no); } } }
作业:多种线索化 import lombok.Data;public class ThreadedBinaryTreeDemo { public static void main (String[] args) { ThreadedTreeNode root = getTree(); ThreadedTree tree = new ThreadedTree (root); tree.postThreadedNodes(root); tree.listPostThreadedNodes(root); } public static ThreadedTreeNode getTree () { ThreadedTreeNode node1 = new ThreadedTreeNode (1 ); ThreadedTreeNode node2 = new ThreadedTreeNode (2 ); ThreadedTreeNode node3 = new ThreadedTreeNode (3 ); ThreadedTreeNode node4 = new ThreadedTreeNode (4 ); ThreadedTreeNode node5 = new ThreadedTreeNode (5 ); ThreadedTreeNode node6 = new ThreadedTreeNode (6 ); ThreadedTreeNode node7 = new ThreadedTreeNode (7 ); node1.setLeft(node2); node1.setRight(node3); node2.setLeft(node4); node2.setRight(node5); node3.setLeft(node6); node3.setRight(node7); return node1; } } @Data class ThreadedTree { private ThreadedTreeNode root; private ThreadedTreeNode pre; public ThreadedTree (ThreadedTreeNode root) { this .root = root; } public void preThreadedNodes (ThreadedTreeNode node) { if (node == null ) { return ; } if (node.getLeft() == null ) { node.setLeft(pre); node.setLeftType(1 ); } if (pre != null && pre.getRight() == null ) { pre.setRight(node); pre.setRightType(1 ); } pre = node; if (node.getLeftType() == 0 ) { preThreadedNodes(node.getLeft()); } if (node.getRightType() == 0 ) { preThreadedNodes(node.getRight()); } } public void midThreadedNodes (ThreadedTreeNode node) { if (node == null ) { return ; } midThreadedNodes(node.getLeft()); if (node.getLeft() == null ) { node.setLeft(pre); node.setLeftType(1 ); } if (pre != null && pre.getRight() == null ) { pre.setRight(node); pre.setRightType(1 ); } pre = node; midThreadedNodes(node.getRight()); } public void postThreadedNodes (ThreadedTreeNode node) { if (node == null ) { return ; } if (node.getLeftType() == 0 ) { postThreadedNodes(node.getLeft()); } if (node.getRightType() == 0 ) { postThreadedNodes(node.getRight()); } if (node.getLeft() == null ) { node.setLeft(pre); node.setLeftType(1 ); } if (pre != null && pre.getRight() == null ) { pre.setRight(node); pre.setRightType(1 ); } pre = node; } public void listPreThreadedNodes () { ThreadedTreeNode node = root; while (node != null ){ System.out.println(node.getVal()); while (node.getLeftType() == 0 ){ node = node.getLeft(); System.out.println(node.getVal()); } node = node.getRight(); } } public void listMidThreadedNodes () { ThreadedTreeNode node = root; while (node != null ){ while (node.getLeftType() == 0 ){ node = node.getLeft(); } System.out.println(node.getVal()); while (node.getRightType() == 1 ){ node = node.getRight(); System.out.println(node.getVal()); } node = node.getRight(); } } public void listPostThreadedNodes (ThreadedTreeNode node) { if (node.getLeft () != null && node.getLeftType() == 0 ) { listPostThreadedNodes(node.getLeft()); } if (node.getRight() != null && node.getRightType() == 0 ) { listPostThreadedNodes(node.getRight()); } System.out.println(node.getVal()); } } @Data class ThreadedTreeNode { private Integer val; private ThreadedTreeNode left; private ThreadedTreeNode right; private Integer leftType = 0 ; private Integer rightType = 0 ; public ThreadedTreeNode (Integer val) { this .val = val; } @Override public String toString () { return "TreeNode{" + "val=" + val + '}' ; } }
线索化比较
前序线索化二叉树
遍历相对最容易理解,实现起来也比较简单。由于前序遍历的顺序是:根左右,所以从根节点开始,沿着左子树进行处理,当子节点的left指针类型是线索时,说明到了最左子节点,然后处理子节点的right指针指向的节点,可能是右子树,也可能是后继节点,无论是哪种类型继续按照上面的方式(先沿着左子树处理,找到子树的最左子节点,然后处理right指针指向),以此类推,直到节点的right指针为空,说明是最后一个,遍历完成。
中序线索化二叉树
中序遍历的顺序是:左根右,因此第一个节点一定是最左子节点,先找到最左子节点,依次沿着right指针指向进行处理(无论是指向子节点还是指向后继节点),直到节点的right指针为空,说明是最后一个,遍历完成。
后序线索化二叉树
最为复杂,通用的二叉树数节点存储结构不能够满足后序线索化,因此我们扩展了节点的数据结构,增加了父节点的指针。后序的遍历顺序是:左右根,先找到最左子节点,沿着right后继指针处理,当right不是后继指针时,并且上一个处理节点是当前节点的右节点,则处理当前节点的右子树,遍历终止条件是:当前节点是root节点,并且上一个处理的节点是root的right节点。
实际应用 堆排序 概述
排序思路 步骤一 构造初始堆。将给定无序序列构造成一个大顶堆(一般升序采用大顶堆,降序采用小顶堆)。
.假设给定无序序列结构如下
.此时我们从最后一个非叶子结点开始(叶结点自然不用调整,第一个非叶子结点 arr.length/2-1=5/2-1=1 ,也就是下面的6结点),从左至右,从下至上进行调整。
.找到第二个非叶节点4,由于[4,9,8]中9元素最大,4和9交换。
这时,交换导致了子根[4,5,6]结构混乱,继续调整,[4,5,6]中6最大,交换4和6。
此时,我们就将一个无序序列构造成了一个大顶堆。
步骤二 将堆顶元素与末尾元素进行交换,使末尾元素最大。然后继续调整堆,再将堆顶元素与末尾元素交换,得到第二大元素。如此反复进行交换、重建、交换。
.将堆顶元素9和末尾元素4进行交换
.重新调整结构,使其继续满足堆定义
.再将堆顶元素8与末尾元素5进行交换,得到第二大元素8.
后续过程,继续进行调整,交换,如此反复进行,最终使得整个序列有序
排序规则
将无序序列构建成一个堆,根据升序降序需求选择大顶堆或小顶堆,整个序列的最大值/最小值就是堆顶的根节点。 将堆顶元素与末尾元素交换,将最大元素”沉”到数组末端; 重新调整结构,使其满足堆定义,然后继续交换堆顶元素与当前末尾元素(然后将剩余n-1个元素重新构造成一个堆,这样会得到n个元素的次小值。),反复执行调整+交换步骤,直到整个序列有序。 代码实现:升序
代码实现 import java.text.SimpleDateFormat;import java.util.Date;public class HeapSort { public static void main (String[] args) { int [] arr = new int [800000 ]; for (int i = 0 ; i < 800000 ; i++) { arr[i] = (int ) (Math.random() * 800000 ); } Date date1 = new Date (); SimpleDateFormat simpleDateFormat = new SimpleDateFormat ("yyyy-MM-dd HH:mm:ss" ); String date1Str = simpleDateFormat.format(date1); System.out.println("排序前的时间是:" + date1Str); heapSort(arr); Date date2 = new Date (); String date2Str = simpleDateFormat.format(date2); System.out.println("排序后的时间是:" + date2Str); } public static void heapSort (int [] arr) { int temp = 0 ; for (int i = arr.length / 2 - 1 ; i >= 0 ; i--) { adjustHeap(arr, i, arr.length); } for (int j = arr.length - 1 ; j > 0 ; j--) { temp = arr[j]; arr[j] = arr[0 ]; arr[0 ] = temp; adjustHeap(arr, 0 , j); } } public static void adjustHeap (int arr[], int i, int length) { int temp = arr[i]; for (int k = i * 2 + 1 ; k < length; k = k * 2 + 1 ) { if (k + 1 < length && arr[k] < arr[k + 1 ]) { k++; } if (arr[k] > temp) { arr[i] = arr[k]; i = k; } else { break ; } } arr[i] = temp; } }
优先队列 普通的队列是一种先进先出的数据结构,元素在队列尾追加,而从队列头删除。在某些情况下,我们可能需要找出队列中的最大值或者最小值,例如使用一个队列保存计算机的任务,一般情况下计算机的任务都是有优先级的,我们需要在这些计算机的任务中找出优先级最高的任务先执行,执行完毕后就需要把这个任务从队列中移除。普通的队列要完成这样的功能,需要每次遍历队列中的所有元素,比较并找出最大值,效率不是很高,这个时候,我们就可以使用一种特殊的队列来完成这种需求,优先队列。
优先队列按照其作用不同,可以分为以下两种:
最大优先队列(大顶堆实现) 我们前面学习堆的时候,堆中存放数据元素的数组要满足都满足如下特性:
最大的元素放在数组的索引1处。 每个结点的数据总是大于等于它的两个子结点的数据。
我们之前学习过堆,而堆这种结构是可以方便的删除最大的值,所以,接下来我们可以基于堆区实现最大优先队列。
代码实现 public class MaxPriorityQueue <T extends Comparable <T>> { private T[] items; private int N; public MaxPriorityQueue (int capacity) { this .items = (T[]) new Comparable [capacity]; this .N = 0 ; } public int size () { return N; } public boolean isEmpty () { return N == 0 ; } private boolean less (int i, int j) { return items[i].compareTo(items[j]) < 0 ; } private void exch (int i, int j) { T tmp = items[i]; items[i] = items[j]; items[j] = tmp; } public void insert (T t) { items[++N] = t; swim(N); } public T delMax () { T max = items[1 ]; exch(1 , N); N--; sink(1 ); return max; } public void swim (int k) { while (k > 1 ) { if (less(k / 2 , k)) { exch(k / 2 , k); } k = k / 2 ; } } public void sink (int k) { while (2 * k <= N) { int max; if (2 * k + 1 <= N) { if (less(2 * k, 2 * k + 1 )) { max = 2 * k + 1 ; } else { max = 2 * k; } } else { max = 2 * k; } if (!less(k, max)) { break ; } exch(k, max); k = max; } } } class MaxPriorityQueueDemo { public static void main (String[] args) { MaxPriorityQueue<Integer> queue = new MaxPriorityQueue <>(10 ); queue.insert(1 ); queue.insert(2 ); queue.insert(3 ); queue.insert(4 ); queue.insert(5 ); queue.insert(6 ); queue.insert(7 ); queue.insert(8 ); while (!queue.isEmpty()) { Integer i = queue.delMax(); System.out.println(i); } } }
最小优先队列(小顶堆) 最小优先队列实现起来也比较简单,我们同样也可以基于堆来完成最小优先队列。
实我们之前实现的堆可以把它叫做最大堆,我们可以用相反的思想实现最小堆,让堆中存放数据元素的数组满足如下特性:
最小的元素放在数组的索引1处。 每个结点的数据总是小于等于它的两个子结点的数据。
代码实现 public class MinPriorityQueue <T extends Comparable <T>> { private T[] items; private int N; public MinPriorityQueue (int capacity) { this .items = (T[]) new Comparable [capacity + 1 ]; this .N = 0 ; } public int size () { return N; } public boolean isEmpty () { return N == 0 ; } private boolean less (int i, int j) { return items[i].compareTo(items[j]) < 0 ; } private void exch (int i, int j) { T tmp = items[i]; items[i] = items[j]; items[j] = tmp; } public void insert (T t) { items[++N] = t; swim(N); } public T delMax () { T min = items[1 ]; exch(1 , N); N--; sink(1 ); return min; } public void swim (int k) { while (k > 1 ) { if (less(k, k / 2 )) { exch(k, k / 2 ); } k = k / 2 ; } } public void sink (int k) { while (2 * k <= N) { int min; if (2 * k + 1 <= N) { if (less(2 * k, 2 * k + 1 )) { min = 2 * k; } else { min = 2 * k + 1 ; } } else { min = 2 * k; } if (less(k, min)) { break ; } exch(k, min); k = min; } } } class MinPriorityQueueDemo { public static void main (String[] args) { MinPriorityQueue<Integer> queue = new MinPriorityQueue <>(10 ); queue.insert(1 ); queue.insert(2 ); queue.insert(3 ); queue.insert(4 ); queue.insert(5 ); queue.insert(6 ); queue.insert(7 ); queue.insert(8 ); while (!queue.isEmpty()) { Integer i = queue.delMax(); System.out.println(i); } } }
索引优先队列 概述 在之前实现的最大优先队列和最小优先队列,他们可以分别快速访问到队列中最大元素和最小元素 ,但是他们有一个缺点,就是没有办法通过索引访问已存在于优先队列中的对象 ,并更新它们。为了实现这个目的,在优先队列的基础上,学习一种新的数据结构,索引优先队列。接下来我们以最小优先队列举列 。
思路分析 步骤一:
存储数据时,给每一个数据元素关联一个整数,例如insert(int k,T t),我们可以看做k是t关联的整数,那么我们的实现需要通过k这个值,快速获取到队列中t这个元素,此时有个k这个值需要具有唯一性。
最直观的想法就是我们可以用一个T[] items数组来保存数据元素,在insert(int k.T t)完成插入时,可以把k看做是items数组的索引,把t元素放到items数组的索引k处,这样我们再根据k获取元素t时就很方便了》,直接就可以拿到items[k]即可。
步骤二:
步骤一完成后的结果,虽然我们给每个元素关联了一个整数,组可以使用这个整数快速的获取到该元素,但是, items数组中的元素顺序是随机的,并环是堆有序的,所以,为了完成这个求,我们可以增加一个数组int]pq,来保存每个元素在items数组中的索引,pq数组需要堆有序,也就是说,pq[1 ]对应的数据元素items[pq[1]要小于等于pq[2]和pq[3]对应的数据元素items[pq[]]和items[pq[3]]。
步骤三
最直观的想法就是遍历pq数组,让每一个元素和0做比较,如果当前元索是0,那么调整该索引处的元索即可,但是效率很低。
我们可以另外增加一个数组,int[] qp,用来存储pq的逆序。例如:
当有了pq数组后,如果我们修改item[0]=”H”,那么就可以想通过索引0,在qp数组中找到qp的索引:qp[0]=9,那么直接调整pq[9]即可。
代码实现 public class IndexMinPriorityQueue <T extends Comparable <T>> { private T[] items; private int [] pq; private int [] qp; private int N; public IndexMinPriorityQueue (int capacity) { this .items = (T[]) new Comparable [capacity + 1 ]; this .pq = new int [capacity + 1 ]; this .qp = new int [capacity + 1 ]; this .N = 0 ; for (int i = 0 ; i < qp.length; i++) { qp[i] = -1 ; } } public int size () { return N; } public boolean inEmpty () { return N == 0 ; } private boolean less (int i, int j) { return items[pq[i]].compareTo(items[pq[j]]) < 0 ; } private void exch (int i, int j) { int tmp = pq[i]; pq[i] = pq[j]; pq[j] = tmp; qp[pq[i]] = i; qp[pq[j]] = j; } public boolean contains (int k) { return qp[k] != -1 ; } public int minIndex () { return pq[1 ]; } public void insert (int i, T t) { if (contains(i)) { return ; } N++; items[i] = t; pq[N] = i; qp[i] = N; swim(N); } public int delMin () { int minIndex = pq[1 ]; exch(1 , N); qp[pq[N]] = -1 ; pq[N] = -1 ; items[minIndex] = null ; N--; sink(1 ); return minIndex; } public void delete (int i) { int k = pq[i]; exch(k, N); qp[pq[N]] = -1 ; pq[N] = -1 ; items[k] = null ; N--; sink(k); swim(k); } public void changeItem (int i, T t) { items[i] = t; int k = qp[i]; sink(k); swim(k); } private void swim (int k) { while (k > 1 ) { if (less(k, k / 2 )) { exch(k, k / 2 ); } k = k / 2 ; } } private void sink (int k) { while (2 * k <= N) { int min; if (2 * k + 1 <= N) { if (less(2 * k, 2 * k + 1 )) { min = 2 * k; } else { min = 2 * k + 1 ; } } else { min = 2 * k; } if (less(k, min)) { break ; } exch(k, min); k = min; } } } class IndexMinPriorityQueueDemo { public static void main (String[] args) { IndexMinPriorityQueue queue = new IndexMinPriorityQueue (10 ); queue.insert(0 , "A" ); queue.insert(1 , "B" ); queue.insert(2 , "C" ); queue.insert(3 , "D" ); queue.insert(4 , "E" ); queue.insert(5 , "F" ); queue.insert(6 , "G" ); queue.insert(7 , "H" ); queue.insert(8 , "I" ); queue.changeItem(0 , "S" ); while (!queue.inEmpty()) { int index = queue.delMin(); System.out.println(index+ " " ); } } }
赫尔曼树 概述
给定n个权值作为n个叶子结点 ,构造一棵二叉树,若该树的带权路径长度(wpl)达到最小,称这样的二叉树为最优二叉树 ,也称为哈夫曼树 (Huffman Tree),还有的书翻译为霍夫曼树 。
赫夫曼树是带权路径长度最短的树,权值较大的结点离根较近。
重要概念
路径和路径长度 :在一棵树中,从一个结点往下可以达到的孩子或孙子结点之间的通路,称为路径。通路中分支的数目称为路径长度。若规定根结点的层数为1,则从根结点到第L层结点的路径长度为L-1结点的权及带权路径长度 :若将树中结点赋给一个有着某种含义的数值,则这个数值称为该结点的权。结点的带权路径长度为 :从根结点到该结点之间的路径长度与该结点的权的乘积树的带权路径长度 :树的带权路径长度规定为所有叶子结点的带权路径长度之和,记为WPL(weighted path length) ,权值越大的结点离根结点越近的二叉树才是最优二叉树。WPL最小的就是赫夫曼树
实例 给你一个数列 {13, 7, 8, 3, 29, 6, 1},要求转成一颗赫夫曼树。
构成赫夫曼树的四个步骤
从小到大进行排序, 将每一个数据,每个数据都是一个节点 , 每个节点可以看成是一颗最简单的二叉树。
取出根节点权值最小的两颗二叉树
组成一颗新的二叉树, 该新的二叉树的根节点的权值是前面两颗二叉树根节点权值的和
再将这颗新的二叉树,以根节点的权值大小再次排序,不断重复1、2、3、4的步骤,直到数列中,所有的数据都被处理,就得到一颗赫夫曼树。
{13, 7, 8, 3, 29, 6, 1}=>{1,3,6,7,8,13,29}
代码实现 import java.util.ArrayList;import java.util.Collections;import java.util.List;public class HuffmanTree { public static void main (String[] args) { int arr[] = {13 , 7 , 8 , 3 , 29 , 6 , 1 }; Node node = creatHuffmanTree(arr); preOrder(node); } public static void preOrder (Node root) { if (root != null ) { root.preOrder(); } else { System.out.println("空树" ); } } public static Node creatHuffmanTree (int [] arr) { List<Node> nodes = new ArrayList <Node>(); for (int value : arr) { nodes.add(new Node (value)); } while (nodes.size() > 1 ) { Collections.sort(nodes); Node leftNode = nodes.get(0 ); Node rightNode = nodes.get(1 ); Node parent = new Node (leftNode.value + rightNode.value); parent.left = leftNode; parent.right = rightNode; nodes.remove(leftNode); nodes.remove(rightNode); nodes.add(parent); } return nodes.get(0 ); } } class Node implements Comparable <Node> { int value; Node left; Node right; public void preOrder () { System.out.println(this ); if (this .left != null ) { this .left.preOrder(); } if (this .right != null ) { this .right.preOrder(); } } public Node (int value) { this .value = value; } @Override public String toString () { return "Node{" + "value=" + value + '}' ; } @Override public int compareTo (Node o) { return this .value - o.value; } }
赫尔曼编码 二叉树排序 给你一个数列 (7, 3, 10, 12, 5, 1, 9),要求能够高效的完成对数据的查询和添加。
概述 二叉排序树:BST: (Binary Sort(Search) Tree),对于二叉排序树的任何一个非叶子节点,要求左子节点的值比当前节点的值小 ,右子节点的值比当前节点的值大 。
特别说明 :如果有相同的值,可以将该节点放在左子节点或右子节点
比如针对前面的数据 (7, 3, 10, 12, 5, 1, 9) ,对应的二叉排序树为:
思路分析 创建
左子节点的值比当前节点的值小, 右子节点的值比当前节点的值大。
删除
二叉排序树的删除情况比较复杂,有下面三种情况需要考虑:
第一种情况:删除叶子节点 (比如:2,5,9,12)
需求先去找到要删除的结点 targetNode
找到 targetNode 的 父结点 parent
确定 targetNode 是 parent的左子结点 还是右子结点
根据前面的情况来对应删除
左子结点 parent.left = null
右子结点 parent.right = null;
第二种情况:删除只有一颗子树的节点 (比如 1)
需求先去找到要删除的结点 targetNode
找到 targetNode 的 父结点 parent
确定 targetNode 的子结点是左子结点还是右子结点
确定 targetNode 是 parent 的左子结点还是右子结点
如果 targetNode 有左子结点
如果 targetNode 是 parent 的左子结点
parent.left = targetNode.left;
如果 targetNode 是 parent 的右子结点
parent.right = targetNode.left;
如果 targetNode 有右子结点
如果 targetNode 是 parent 的左子结点
如果 targetNode 是 parent 的右子结点
情况三:删除有两颗子树的节点 (比如:7,3,10 )
需求先去找到要删除的结点 targetNode
找到 targetNode 的父结点 parent
从 targetNode 的右子树找到最小的结点
用一个临时变量 temp ,将最小结点的值保存 (temp=11)
删除该最小结点
targetNode.value = temp
代码实现 public class BinarySortTreeDemo { public static void main (String[] args) { int arr[] = {7 , 3 , 10 , 12 , 5 , 1 , 9 }; BinarySortTree binarySortTree = new BinarySortTree (); for (int i = 0 ; i < arr.length; i++) { binarySortTree.add(new Node (arr[i])); } binarySortTree.infisOrder(); binarySortTree.delNode(2 ); binarySortTree.delNode(5 ); binarySortTree.delNode(9 ); binarySortTree.delNode(10 ); System.out.println("测试删除节点后" ); binarySortTree.infisOrder(); } } class BinarySortTree { private Node root; public Node search (int value) { if (root == null ) { return null ; } else { return root.search(value); } } public Node searchParent (int value) { if (root == null ) { return null ; } else { return root.searchParent(value); } } public int delRightTreeMin (Node node) { Node target = node; while (target.left != null ) { target = target.left; } delNode(target.value); return target.value; } public int delLeftTreeMax (Node node) { Node target = node; while (target.right != null ) { target = target.right; } delNode(target.value); return target.value; } public void delNode (int value) { if (root == null ) { return ; } else { Node targetNode = search(value); if (targetNode == null ) { return ; } if (root.left == null && root.right == null ) { root = null ; return ; } Node parent = searchParent(value); if (targetNode.left == null && targetNode.right == null ) { if (parent.left != null && parent.left.value == value) { parent.left = null ; } else if (parent.right != null && parent.right.value == value) { parent.right = null ; } } else if (targetNode.left != null && targetNode.right != null ) { int minValue = delRightTreeMin(targetNode.right); targetNode.value = minValue; } else { if (targetNode.left != null ) { if (parent != null ) { if (parent.left.value == value) { parent.left = targetNode.left; } else { parent.right = targetNode.left; } } else { root = targetNode.left; } } else { if (parent != null ) { if (parent.left.value == value) { parent.left = targetNode.right; } else { parent.right = targetNode.right; } } else { root = targetNode.right; } } } } } public void add (Node node) { if (root == null ) { root = node; } else { root.add(node); } } public void infisOrder () { if (root != null ) { root.infisOrder(); } else { System.out.println("空树,不可遍历" ); } } } class Node { int value; Node left; Node right; public Node (int value) { this .value = value; } @Override public String toString () { return "Node{" + "value=" + value + '}' ; } public void add (Node node) { if (node == null ) { return ; } if (node.value < this .value) { if (this .left == null ) { this .left = node; } else { this .left.add(node); } } else { if (this .right == null ) { this .right = node; } else { this .right.add(node); } } } public void infisOrder () { if (this .left != null ) { this .left.infisOrder(); } System.out.println(this ); if (this .right != null ) { this .right.infisOrder(); } } public Node search (int value) { if (value == this .value) { return this ; } else if (value < this .value) { if (this .left == null ) { return null ; } return this .left.search(value); } else { if (this .right == null ) { return null ; } return this .right.search(value); } } public Node searchParent (int value) { if ((this .left != null && this .left.value == value) || (this .right != null && this .right.value == value)) { return this ; } else { if (this .value <= value && this .right != null ) { return this .right.searchParent(value); } if (this .value > value && this .left != null ) { return this .left.searchParent(value); } return null ; } } }
平衡二叉树(AVL树) 引出问题 给你一个数列{1,2,3,4,5,6},要求创建一颗二叉排序树(BST), 并分析问题所在.
左边BST 存在的问题分析:
左子树全部为空,从形式上看,更像一个单链表。
插入速度没有影响
查询速度明显降低(因为需要依次比较),不能发挥BST的优势,因为每次还需要比较左子树,其查询速度比单链表还慢
解决方案——平衡二叉树(AVL)
基本介绍
平衡二叉树也叫平衡二叉搜索树(Self-balancing binary search tree)又被称为AVL树,可以保证查询效率较高 。
具有以下特点:它是一 棵空树或它的左右两个子树的高度差的绝对值不超过1,并且左右两个子树都是一棵平衡二叉树。平衡二叉树的常用实现方法有红黑树 、AVL 、替罪羊树 、Treap 、伸展树 等。
举例说明,看看下面哪些AVL树,为什么?
左旋转 要求 给你一个数列,创建出对应的平衡二叉树,数列 {4,3,6,5,7,8}
思路分析
代码实现 public void leftRotate () { Node newNode = new Node (value); newNode.left = left; newNode.right = right.left; value = right.value; right = right.right; left = newNode; }
之前:
之后:
右旋转 要求 给你一个数列,创建出对应的平衡二叉树.数列 {10,12, 8, 9, 7, 6}
思路分析
代码实现 public void lightRotate () { Node newNode = new Node (value); newNode.right = right; newNode.left = left.right; value = left.value; left = left.left; right = newNode; }
旋转前:
旋转后:
双旋树 问题 前面的两个数列,进行单旋转(即一次旋转)就可以将非平衡二叉树转成平衡二叉树,但是在某些情况下,单旋转不能完成平衡二叉树的转换。比如数列
int[] arr = { 10, 11, 7, 6, 8, 9 }; 运行原来的代码可以看到,并没有转成 AVL树.
int[] arr = {2,1,6,5,7,3}; // 运行原来的代码可以看到,并没有转成 AVL树
原因
思路分析
当符号右旋转的条件时
如果它的左子树的右子树高度大于它的左子树的高度
先对当前这个结点的左节点进行左旋转(7)
在对当前结点进行右旋转的操作即可
代码实现 if (rightHeight() - leftHeight() > 1 ) { if (right != null && right.rightHeight() < right.leftHeight()) { right.rightRotate(); leftRotate(); } leftRotate(); } else if (leftHeight() - rightHeight() > 1 ) { if (left != null && left.leftHeight() < left.rightHeight()) { left.leftRotate(); rightRotate(); } rightRotate(); }
总结 方法类:
public class AVLTreeDemo { public static void main (String[] args) { int arr1[] = {4 , 3 , 6 , 5 , 7 , 8 }; AVLTree leftavlTree = new AVLTree (); for (int i = 0 ; i < arr1.length; i++) { leftavlTree.add(new Node (arr1[i])); } leftavlTree.infisOrder(); System.out.println("树的高度:" + leftavlTree.getRoot().height()); System.out.println("左子树高度:" + leftavlTree.getRoot().leftHeight()); System.out.println("右子树高度:" + leftavlTree.getRoot().rightHeight()); int arr2[] = {10 , 12 , 8 , 9 , 7 , 6 }; AVLTree rightavlTree = new AVLTree (); for (int i = 0 ; i < arr2.length; i++) { rightavlTree.add(new Node (arr2[i])); } rightavlTree.infisOrder(); System.out.println("树的高度:" + rightavlTree.getRoot().height()); System.out.println("左子树高度:" + rightavlTree.getRoot().leftHeight()); System.out.println("右子树高度:" + rightavlTree.getRoot().rightHeight()); int arr3[] = {10 , 12 , 8 , 9 , 7 , 6 }; AVLTree avlTree = new AVLTree (); for (int i = 0 ; i < arr3.length; i++) { avlTree.add(new Node (arr3[i])); } avlTree.infisOrder(); System.out.println("树的高度:" + avlTree.getRoot().height()); System.out.println("左子树高度:" + avlTree.getRoot().leftHeight()); System.out.println("右子树高度:" + avlTree.getRoot().rightHeight()); } }
输出结果:
Node{value=3 } Node{value=4 } Node{value=5 } Node{value=6 } Node{value=7 } Node{value=8 } 树的高度:3 左子树高度:2 右子树高度:2 Node{value=6 } Node{value=7 } Node{value=8 } Node{value=9 } Node{value=10 } Node{value=12 } 树的高度:3 左子树高度:2 右子树高度:2 Node{value=6 } Node{value=7 } Node{value=8 } Node{value=9 } Node{value=10 } Node{value=12 } 树的高度:3 左子树高度:2 右子树高度:2
右大于左,左旋转
左大于右,右旋转
add方法:
public void add (Node node) { if (node == null ) { return ; } if (node.value < this .value) { if (this .left == null ) { this .left = node; } else { this .left.add(node); } } else { if (this .right == null ) { this .right = node; } else { this .right.add(node); } } if (rightHeight() - leftHeight() > 1 ) { leftRotate(); } else if (leftHeight() - rightHeight() > 1 ) { rightRotate(); } if (rightHeight() - leftHeight() > 1 ) { if (right != null && right.rightHeight() > right.leftHeight()) { right.rightRotate(); leftRotate(); } leftRotate(); } else if (leftHeight() - rightHeight() > 1 ) { if (left != null && left.leftHeight() > left.rightHeight()) { left.leftRotate(); rightRotate(); } rightRotate(); } }
多路查找树 二叉树与B树 二叉树 二叉树的操作效率较高,但是也存在问题, 请看下面的二叉树
二叉树需要加载到内存的,如果二叉树的节点少,没有什么问题,但是如果二叉树的节点很多(比如1亿),就存在如下问题:
问题1: 在构建二叉树时,需要多次进行I/O操作(海量数据存在数据库或文件中),节点海量,构建二叉树时,速度有影响问题2: 节点海量,也会造成二叉树的高度很大,会降低操作速度。
多叉树
在二叉树中,每个节点有数据项,最多有两个子节点。如果允许每个节点可以有更多的数据项和更多的子节点 ,就是多叉树 (multiway tree)
后面我们讲解的2-3树,2-3-4树就是多叉树,多叉树通过重新组织节点,减少树的高度,能对二叉树进行优化 。举例说明(下面2-3树就是一颗多叉树)
B数 B树通过重新组织节点,降低树的高度,并且减少i/o读写次数来提升效率。
如图B树通过重新组织节点, 降低了树的高度 。文件系统及数据库系统的设计者利用了磁盘预读原理,将一个节点的大小设为等于一个页(页得大小通常为4k),这样每个节点只需要一次I/O就可以完全载入 。将树的度M设置为1024,在600亿个元素中最多只需要4次I/O操作就可以读取到想要的元素, B树(B+)广泛应用于文件存储系统以及数据库系统中
2-3树 2-3树是最简单的B树结构,为了保证查找树的平衡性,我们需要一些灵活性,因此在这里我们允许树中的一个结点保存多个键。确切的说,我们将一棵标准的二叉查找树中的结点称为2-结点(含有一个键和两条链),而现在我们引入3-结点,它含有两个键和三条链。2-结点和3-结点中的每条链都对应着其中保存的键所分割产生的一个区间。
2-结点:
含有一个键 (及其对应的值)和两条链 ,左链接指向2-3树中的键都小于该结点,右链接指向的2-3树中的键都大于该结点。
3-结点:
含有两个键 (及其对应的值)和三条链 ,左链接指向的2-3树中的键都小于该结点,中链接指向的2-3树中的键都位于该结点的两个键之间,右链接指向的2-3树中的键都大于该结点。
特点
2-3树的所有叶子节点都在同一层.(只要是B树都满足这个条件)
有两个子节点的节点叫二节点,二节点要么没有子节点,要么有两个子节点.
有三个子节点的节点叫三节点,三节点要么没有子节点,要么有三个子节点.
2-3树是由二节点和三节点构成的树。
查找 将二叉查找树的查找算法一般化我们就能够直接得到2-3树的查找算法。要判断一个键是否在树中,我们先将它和根结点中的键比较。如果它和其中任意一个相等,查找命中;否则我们就根据比较的结果找到指向相应区间的连接,并在其指向的子树中递归地继续查找。如果这个是空链接,查找未命中。
插入
2-3树的所有叶子节点都在同一层。(只要是B树都满足这个条件) 有两个子节点的节点叫二节点,二节点要么没有子节点,要么有两个子节点。 有三个子节点的节点叫三节点,三节点要么没有子节点,要么有三个子节点。 当按照规则插入一个数到某个节点时,不能满足上面三个要求,就需要拆,先向上拆,如果上层满,则拆本层,拆后仍然需要满足上面3个条件。 对于三节点的子树的值大小仍然遵守。(BST 二叉排序树)的规则)
1.向2-结点中插入新键 往2-3树中插入元素和往二叉查找树中插入元素一样,首先要进行查找,然后将节点挂到未找到的节点上。2-3树之所以能够保证在最差的情况下的效率的原因在于其插入之后仍然能够保持平衡状态。如果查找后未找到的节点是一个2-结点,那么很容易,我们只需要将新的元素放到这个2-结点里面使其变成一个3-结点即可。但是如果查找的节点结束于一个3-结点,那么可能有点麻烦。
2.向一棵只含有一个3-结点的树中插入新键 假设2-3树只包含一个3-结点,这个结点有两个键,没有空间来插入第三个键了,最自然的方式是我们假设这个结点能存放三个元素,暂时使其变成一个4结点,同时他包含四条链接。然后,我们将这个4结点的中间元素提升,左边的键作为左子结点,右边的键作为其右子结点。插入完成,变为平衡2-3查找树,树的高度从0变为1。
3.向一个父节点为2-结点的3-结点中插入新键 和上面的情况一样,我们也可以将新的元素插入到3-结点中,使其成为一个临时的4-结点,然后,将该结点中的中间元素提升到父结点即2结点中,使其父结点成为一个3-结点,然后将左右结点分别挂在这个3-结点的恰当位置。
4.向一个父节点为3-结点的3-结点中插入新键 当我们插入的结点是3结点的时候,我们将该结点拆分,中间元素提升至父结点,但是此时父结点是一个3结点 ,插入之后,父结点变成了4结点,然后继续将中间元素提升至其父结点,直至遇到一个父结点是2-结点,然后将其变为3结点,不需要继续进行拆分。
5.分解根节点 当插入结点到根结点的路径上全部是3结点的时候,最终我们的根结点会编程一个临时的4-结点,此时,就需要将根结点拆分为两个2-结点,树的高度加1。
性质 通过对2-3树插入操作的分析,我们发现在插入的时候, 2-3树需要做一些局部的变换来保持2-3树的平衡。
一棵完全平衡的2-3树具有以下性质:
任意空链接到根结点的路径长度都是相等的。
4-结点变换为3-结点时,树的高度不会发生变化(4),只有当根结点是临时的4-结点。分解根结点时,树高+1(5)。
2-3树与普通二叉查找树最大的区别在于,普通的二叉查找树是自顶向下生长,而2-3树是自底向上生长。
总结 直接实现2-3树比较复杂,因为:
要处理不同的结点类型,非常繁琐;
需要多次比较操作来将结点下移;
要上移来拆分4-结点;
拆分4结点的情况有很多种;
2-3查找树实现起来比较复杂,在某些情况插入后的平衡操作可能会使得效率降低。但是2-3查找树作为一种比较重要的概念和思路对于我们后面要讲到的红黑树、B树和B+树非常重要。
红黑树 概述 我们前面介绍了2-3树,可以看到2-3树能保证在插入元素之后,树依然保持平衡状态,它的最坏情况下所有子结点都是2-结点,树的高度为IogN,相比于我们普通的二叉查找树,最坏情况下树的高度为N,确实保证了最坏情况下的时间复杂度,但是2-3树实现起来过于复杂,所以我们介绍一种2-3树思想的简单实现:红黑树。
红链接: 将两个2-结点连接起来构成一个3-结点
黑链接: 则是2-3树中的普遍链接
确切的说,我们将3-结点表示为由一条左斜的红色链接(两个2结点其中之一是另一个的左子结点相连的两个2结点。这种表示法的一个优点是,我们无需修改就可以直接使用标准的二叉查找树的get方法。
定义 红黑树是含有红黑链接并满足下列条件的二叉查找树:
红链接均为左链接;
没有任何一个结点同时和两条红链按相连;(存在四链接)
该树是完美黑色平衡的,即任意空链按到根结点的路径上的黑链接数量相同;
下面是红黑树与2-3树的对应关系:
思路分析 用一个boolean值来表示颜色,true为红链接,false为黑链接。
树的操作 平衡化 在对红黑树进行一些增删改查的操作后,很有可能会出现红色的右链接或者两条连续红色的链接,而这些都不满足红黑树的定义,所以我们需要对这些情况通过旋转进行修复,让红黑树保持平衡。
左旋 ==当某个结点的左子结点为黑色,右子结点为红色,此时需要左旋 。(必须保证左子结点为红色)==
前提: 当前结点为 h ,它的右子结点为 x ;
左旋过程:
让 x 的左子结点变为 h 的右子结点: h.right=x.left;
让 h 成为 x 的左子结点: x.left=h;
让x 的 color 属性变为h 的 color 属性值: x.color=h.color;
让 h 的 color 属性变为红色 : h.color=true;
右旋 ==当某个结点的左子结点是红色,且左子结点的左子结点也是红色,需要右旋。==
前提: 当前结点为 h ,它的左子结点为 x ;
右旋过程:
让 x 的右子结点成为 h 的左子结点: h.left = x.right;
让 h 成为 x 的右子结点: x.right=h;
让 x 的 color 变为 h 的 color 属性值: x.color = h.color;
让h 的 color 为红色 ;
但是右旋后,还是不符合红黑树的定义,这时候还需要一个==颜色反转 ==的操作。
插入 1.向单个2-结点中插入新键
如果新键小于当前结点的键,我们只需要新增一个红色结点即可。
如果新键大于当前结点的键,那么新增的红色结点将会产生一条红色的右链接,此时我们需要通过左旋,把红色右链接变成左链接,插入操作才算完成。
2.向底部的2-结点插入新键 我们会用红链接将新结点和它的父结点相连。如果它的父结点是一个2-结点,那么刚才讨论的两种方式仍然适用。
3.颜色反转 当一个结点的左子结点和右子结点的 color 都为 RED 时,也就是出现了临时的 4- 结点,此时只需要把左子结点和右子点的颜色变为BLACK ,同时让当前结点的颜色变为 RED 即可。
4.向一个双键树中插入新键
新键大于原树中的两个键
新键小于原树中的两个键
新键介于原数中两个键之间
5.根结点的颜色总是黑色 在结点 Node 对象中 color 属性表示的是父结点指向当前结点的连接的颜色,由于根结点不存在父结点, 所以每次插入操作后,我们都需要把根结点的颜色设置为黑色 。
6.向树底部的3-结点插入新键 假设在树的底部的一个 3- 结点下加入一个新的结点。前面我们所讲的 3 种情况都会出现。指向新结点的链接可能是 3-结点的右链接(此时我们只需要转换颜色即可),或是左链接 ( 此时我们需要进行右旋转然后再转换 ) ,或是中链 接( 此时需要先左旋转然后再右旋转,最后转换颜色 ) 。颜色转换会使中间结点的颜色变红,相当于将它送入了父结点。这意味着父结点中继续插入一个新键,我们只需要使用相同的方法解决即可,直到遇到一个2- 结点或者根结点为止。
代码实现
public class RedBlackTree <K extends Comparable <K>, V> { private Node<K, V> root; private int N; private static final boolean RED = true ; private static final boolean BLACK = false ; private class Node <K, V> { private K key; private V value; private Node<K, V> left; private Node<K, V> right; private boolean color; public Node (K key, V value, Node<K, V> left, Node<K, V> right, boolean color) { this .key = key; this .value = value; this .left = left; this .right = right; this .color = color; } } public RedBlackTree () { root = null ; N = 0 ; } public int size () { return N; } public boolean isEmpty () { return N == 0 ; } public boolean isRed (Node<K, V> node) { if (node == null ) return false ; return node.color == RED; } private Node<K, V> rotateLeft (Node<K, V> node) { Node<K, V> rightnode = node.right; node.right = rightnode.left; rightnode.left = node; rightnode.color = node.color; node.color = RED; return rightnode; } private Node<K, V> rotateRight (Node<K, V> node) { Node<K, V> leftnode = node.left; node.left = leftnode.right; leftnode.right = node; leftnode.color = node.color; node.color = RED; return leftnode; } private void flipColors (Node<K, V> node) { node.left.color = BLACK; node.right.color = BLACK; node.color = RED; } public void put (K key, V value) { root = put(root, key, value); root.color = BLACK; } private Node<K, V> put (Node<K, V> node, K key, V value) { if (node == null ) { N++; return new Node <>(key, value, null , null , RED); } int cmp = node.key.compareTo(key); if (cmp > 0 ) { node.left = put(node.left, key, value); } else if (cmp < 0 ) { node.right = put(node.right, key, value); } else { node.value = value; return node; } if (isRed(node.right) && !isRed(node.left)) { node = rotateLeft(node); } if (isRed(node.left) && isRed(node.left.left)) { node = rotateRight(node); } if (isRed(node.left) && isRed((node.right))) { flipColors(node); } return node; } public V get (K key) { return get(root, key); } private V get (Node<K, V> node, K key) { if (node == null ) return null ; int cmp = node.key.compareTo(key); if (cmp > 0 ) { return get(node.left, key); } else if (cmp < 0 ) { return get(node.right, key); } else { return node.value; } } }
class RedBlackTreeDemo { public static void main (String[] args) { RedBlackTree<Integer, String> tree = new RedBlackTree <>(); tree.put(1 , "A" ); tree.put(2 , "B" ); tree.put(3 , "C" ); tree.put(4 , "D" ); tree.put(5 , "E" ); tree.put(6 , "F" ); tree.put(7 , "G" ); tree.put(8 , "H" ); tree.put(9 , "I" ); for (int i = 1 ; i < tree.size(); i++) { System.out.println(tree.get(i)); } } }
B树 B树是一种树状数据结构,它能够存储数据、对其进行排序并允许以O(logn)的时间复杂度进行查找、 顺序读取、插入和删除等操作。
前面已经介绍了2-3树和2-3-4树,他们就是B树(英语:B-tree 也写成B-树),这里我们再做一个说明,我们在学习Mysql时,经常听到说某种类型的索引是基于B树或者B+树的,如图:
特性 B树中允许一个结点中包含多个key,可以是3个、4个、5个甚至更多,并不确定,需要看具体的实现。现在我们选择一个参数M,来构造一个B树,我们可以把它称作是M阶的B树,那么该树会具有如下特点:
每个结点最多有M-1个key,并组以升排列:
每个结点最多能有M个子结点:
根结点至少有两个子结点:
在实际应用中B树的阶数一般都比较大(通常大于100 ) ,所以,即使存储大量的数据,B树的高度仍然比较小,这样在某些应用场景下,就可以体现出它的优势。
存储 若参数M选择为5,那么每个结点最多包含4个键值对,我们以5阶B树为例,看看B树的数据存储。
B树的说明:
B树的阶:节点的最多子节点个数。比如2-3树的阶是3,2-3-4树的阶是4 B树的搜索,从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点 关键字集合分布在整颗树中, 即叶子节点和非叶子节点都存放数据. 搜索有可能在非叶子结点结束 其搜索性能等价于在关键字全集内做一次二分查找
应用 在我们的程序中,不可避免的需要通过IO操作文件,而我们的文件是存储在磁盘上的。计算机操作磁盘上的文件是通过文件系统进行操作的,在文件系统中就使用到了B树这种数据结构。
磁盘 磁盘能够保存大量的数据,从GB-直到TB级 ,但是他的读取速度比较慢,因为涉及到机器操作,读取速度为毫秒级。
磁盘由盘片构成,每个盘片有两面,又称为盘面。盘片中央有一个可以旋转的主轴,他使得盘片以固定的旋转速率旋转,通常是5400rpm或者是7200rpm,一个磁盘中包含了多个这样的盘片并封装在一个密封的容器内 。盘片的每个表面是由一组称为磁道同心圆组成的,每个磁道被划分为了一组扇区,每一个扇区包含相等数量的数据位,通常是512个子节,扇区之间由一些间隙隔开,这些间隙中不存储数据。
磁盘IO
磁盘用磁头来读写存储在盘片表面的位,而磁头连接到一个移动臂上,移动臂沿着盘片半径前后移动,可以将磁头定位到任何磁道上,这称之为寻道操作。一旦定位到磁道后,盘片转动,磁道上的每个位经过磁头时,读写磁头就可以感知到该位的值,也可以修改值。对磁盘的访问时间分为寻道时间 ,旋转时间 ,以及传送时间 。
由于存储介质的特性,磁盘本身存取就比主存慢很多,再加上机械运动耗费,因此为了提高效率,要尽量减少磁盘I/O,减少读写操作 。为了到这个目的,磁盘往往不是严格按需读取,而是每次都会预读,即使只需要一个字节,磁盘也会从这个位置开始,顺序向后读取一定长度的数据放入内存。这样做的理论依据是计算机科学中著名的局部性原理 :当一个数据被用到时,其附近的数据也通常会马上被使用。由于磁盘顺序读取的效率很高(不需要寻道时间,只需很少的旋转时间),因此预读可以提高I/O效率。
页是计算机管理存储器的逻辑块 ,硬件及操作系统往往将主存和磁盘存储区分割为连续的大小相等的块,每个存储块称为一页(1024个字节或其整数倍),预读的长度一般为页的整倍数。
文件系统的设计者利用了磁盘预读原理,将一个结点的大小设为等于一个页(1024个字节或其整数倍),这样每个结点只需要一次I/O就可以完全载入。那么3层的B树可以容纳1024 *1024 *1024差不多10亿个数据,如果换成二叉查找树,则需要30层!假定操作系统一次读取一个节点,并且根节点保留在内存中,那么B树在10亿个数据中查找目标值,只需要小于3次硬盘读取就可以找到目标值,但红黑树需要小于30次,因此B树大大提高了IO的操作效率 。
小结
B树在插入和删除节点的时候如果导致树不平衡,就通过自动调整节点的位置来保持树的自平衡。
关键字集合分布在整棵树中,即叶子节点和非叶子节点都存放数据。搜索有可能在非叶子节点结束
其搜索性能等价于在关键字全集内做一次二分查找。
再举例
B+数 B+树也是一种多路搜索树,基于B树做出了改进 ,主流的DBMS都支持B+树的索引方式,比如MySQL。相比于B-Tree,B+Tree适合文件索引系统 。
B+树是对B树的一种变形树,它与B树的差异在于:
非叶结点仅具有索引作用,也就是说,非叶子结点只存储key,不存储value;
树的所有叶结点构成一个有序链表,可以按照key排序的次序遍历全部数据。
存储 若参数M选择为5,那么每个结点最多包含4个键值对,我们以5阶B+树为例,看看B+树的数据存储。
B+树的说明:
B+树的搜索与B树也基本相同,区别是B+树只有达到叶子结点才命中(B树可以在非叶子结点命中),其性能也等价于在关键字全集做一次二分查找 ==所有关键字都出现在叶子结点的链表中==(即数据只能在叶子节点【也叫稠密索引】),且链表中的关键字(数据)恰好是有序的。 不可能在非叶子结点命中 非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层 更适合文件索引系统 ==B树和B+树各有自己的应用场景,不能说B+树完全比B树好,反之亦然==.
应用 在数据库 的操作中,查询 操作可以说是最频繁的一种操作,因此在设计数据库时,必须要考虑到查询的效率问题, 在很多数据库中,都是用到了B+树来提高查询的效率;
在操作数据库时,我们为了提高查询效率,可以基于某张表的某个字段建立索引 ,就可以提高查询效率,那其实这个索引就是 B+ 树这种数据结构实现的 。
未建立主键索引的查询
执行 ==select * from user where id=18== 需要从第一条数据开始,一直查询到第6条,发现id=18,此时才能查询出目标结果,共需要比较6次;
建立主键索引的查询
执行 ==select * from user where id=18== 时,从索引开始查,效率提高;
区间查询 执行==select * from user where id>=12 and id<=18== ,如果有了索引,由于B+树的叶结点形成了一个有序链表,所以我们只需要找到id为12的叶子结点,按照遍历链表的方式顺序往后查即可,效率非常高。
B树和B+树的对比 B+树的优点:
由于 B+ 树在非叶子结点上不包含真正的数据,只当做索引使用,因此在内存相同的情况下, 能够存放更多的 key 。 B+树的叶子结点都是相连的 ,因此对整棵树的遍历只需要一次线性遍历叶子结点即可。而且由于数据顺序排列并且相连,所以便于区间查找和搜索 。而B树则需要进行每一层的递归遍历。
B树的优点:
由于 B 树的每一个节点都包含 key 和 value,因此我们根据 key查找 value时,只需要找到 key 所在的位置,就能找到 value,但 B+ 树只有叶子结点存储数据,索引每一次查找,都必须一次一次,一直找到树的最大深度处,也就是叶子结点的深度,才能找到value 。
B+树和B树的差异在于以下几点:
B+树有k个孩子的节点就有k个关键字。也就是孩子数量=关键字数,而B树中,孩子数量=关键字数+1。
B+树非叶子节点的关键字也会同时存在在子节点中,并且是在子节点中所有关键字的最大(或最小)。
B+树的非叶子节点仅用于索引,不保存数据记录,跟记录有关的信息都放在叶子节点中。而B树中,非叶子节点既保存索引,也保存数据记录。
B+树所有关键字都在叶子节点出现,叶子节点构成一个有序链表,而且叶子节点本身按照关键字的大小从小到大顺序链接。
B树
B+树
B+树和B树的查询过程差不多,但是B+树和B树有个根本的差异在于,B+树的中间节点并不直接存储数据 。这样的好处都有什么呢?
首先,B+树查询效率更稳定 。因为B+树每次只有访问到叶子节点才能找到对应的数据,而在B树中,非叶子节点也会存储数据,这样就会造成查询效率不稳定的情况,有时候访问到了非叶子节点就可以找到关键字,而有时需要访问到叶子节点才能找到关键字。
其次,B+树的查询效率更高 。这是因为通常B+树比B树更矮胖 (阶数更大, 深度更低),查询所需要的磁盘I/O也会更少。同样的磁盘页大小,B+ 树可以存储更多的节点关键字。
不仅是对单个关键字的查询上,在查询范围上,B+ 树的效率也比B树高 。这是因为所有关键字都出现在B+树的叶子节点中,叶子节点之间会有指针,数据又是递增的,这使得我们范围查找可以通过指针连接查找。而在B树中则需要通过中序遍历才能完成查询范围的查找,效率要低很多。
B*树 B*树是B+树的变体,在B+树的非根和非叶子结点再增加指向兄弟的指针。
B*树的说明:
B 树定义了非叶子结点关键字个数至少为(2/3)从第1个特点我们可以看出,B*树分配新结点的概率比B+树要低,空间使用率更高 。
并查集 并查集是一种树型的数据结构,并查集可以高效地进行如下操作:
查询元素p和元素q是否属于同一组
合并元索p和元素q所在的组
并查集结构 并查集也是一种树型结构,但这棵树跟我们之前讲的二叉树、红黑树、B树等都不一样,这种树的要求比较简单:
每个元索都唯一的对应一个结点;
每一组数据中的多个元素都在同一颗树中;
一个组中的数据对应的树和另外一个组中的数据对应的树之间没有任何联系;
元素在树中并没有子父级关系的硬性要求;
代码实现
构造方法
初始情况下,每个元素都在-个独立的分组中 ,所以,初始情况下,并查集中的数据默认分为N个组;
初始化数组eleAndGroup;
把eleAndGroup数组的索引看做是每个结点存储的元素,把eleAndGroup数组每个索引处的值看做是该结点所在的分组,那么初始化情况下,i 索引处存储的值就是 i。
合并方法
如果p和q已经在同一个分组中,则无需合并
如果p和q不在同一个分组,则只需要将p元素所在组的所有的元素的组标识符修改为q元素所在组的标识符即可
分组数量
代码 public class UF { private int [] eleAndGroup; private int count; public UF (int N) { this .count = N; this .eleAndGroup = new int [N]; for (int i = 0 ; i < eleAndGroup.length; i++) { eleAndGroup[i] = i; } } public int getCount () { return count; } public int find (int p) { return eleAndGroup[p]; } public boolean connected (int p, int q) { return find(p) == find(q); } public void union (int p, int q) { if (connected(p, q)) { return ; } int pGroup = find(p); int qGroup = find(q); for (int i = 0 ; i < eleAndGroup.length; i++) { if (eleAndGroup[i] == pGroup) eleAndGroup[i] = qGroup; } this .count--; } }
应用 如果我们并查集存储的每一个整数表示的是一个大型计算机网络中的计算机 ,则我们就可以通过connected(int p,int g)来检测,该网络中的某两台计算机之间是否连通?如果连通,则他们之间可以通信,如果不连通,则不能通信,此时我们又可以调用union(int p,int q)使得p和q之间连通,这样两台计算机之间就可以通信了。
一般像计算机这样网络型的数据,我们要求网络中的每两个数据之间都是相连通的,也就是说,我们需要调用很多次union方法,使得网络中所有数据相连,其实我们很容易可以得出,如果要让网络中的数据都相连,则我们至少要调用N-1次union方法才可以,但由于我们的union方法中使用for循环遍历了所有的元素,所以很明显,我们之前实现的合并算法的时间复杂度是0(N^2),如果要解决大规模问题,它是不合适的,所以我们需要对算法进行优化。
YF_Tree算法优化 为了提升union算法的性能,我们需要重新设计find方法和union方法的实现,此时我们先需要对我们的之前数据结构中的eleAndGourp数组的含义进行重新设定:
我们仍然让eleAndGroup数组的索引作为某个结点的元素;
eleAndGroup[i]的值不再是当前结点所在的分组标识,而是该结点的==父结点==;
查询方法优化
判断当前元素p的父结点eleAndGroup[p]是不是自己,如果是自己则证明已经是根结点了;
如果当前元素p的父结点不是自己,则让p=eleAndGroup[p],继续找父结点的父结点,直到找到根结点为止;
public int find (int p) { while (true ) { if (p == eleAndGroup[p]) { return p; }else { p = eleAndGroup[p]; } } }
合并方法优化
找到p元素所在树的根结点
找到q元素所在树的根结点
如果p和q已经在同一个树中,则无需合并;
如果p和q不在同一个分组,则只需要将p元素所在树根结点的父结点设置为q元素的根结点即可;
分组数量-1。
public void union (int p, int q) { int pRoot = find(p); int qRoot = find(q); if (pRoot == qRoot ) { return ; } eleAndGroup[pRoot] = qRoot ; this .count--; }
优化后的性能分析 我们优化后的算法union,如果要把并查集中所有的数据连通,仍然至少要调用N-1次union方法,但是,我们发现union方法中已经没有了for循环,所以union算法的时间复杂度由0(N^2)变为了O(N)。
但是这个算法仍然有问题,因为我们之前不仅修改了union算法,还修改了find算法。我们修改前的find算法的时间复杂度在任何情况下都为0(1),但修改后的find算法在最坏情况下是0(N) :
在union方法中调用了find方法,所以在最坏情况下union算法的时间复杂度仍然为O(N^2)。
路径压缩优化 UF_ Tree中最坏情况下union算法的时间复杂度为0(N^2),其最主要的问题在于最坏情况下,树的深度和数组的大小一样,如果我们能够通过一些算法让合并时,生成的树的深度尽可能的小,就可以优化find方法。
之前我们在union算法中,合并树的时候将任意的一棵树连接到了另外一棵树,这种合并方法是比较暴力的,如果我们把并查集中每一棵树的大小记录下来,然后在每次合并树的时候,把较小的树连接到较大的树上,就可以减小树的深度。
只要我们保证每次合并,都能把小树合并到大树上,就能够压缩合并后新树的路径,这样就能提高find方法的效率。为了完成这个需求,我们需要另外一个数组来记录存储每个根结点对应的树中元素的个数,并且需要一些代码调整数组中的值。
代码实现
public void union (int p, int q) { int pRoot = find(p); int qRoot = find(q); if (pRoot == qRoot) { return ; } if (sz[pRoot] < sz[qRoot]) { eleAndGroup[pRoot] = qRoot; sz[qRoot] += sz[pRoot]; } else { eleAndGroup[qRoot] = pRoot; sz[pRoot] += sz[qRoot]; } this .count--; }
案例——畅通工程 问题 某省调查城镇交通状况,得到现有城镇道路统计表,表中列出了每条道路直接连通的城镇。省政府”畅通工程’的目标是使全省任何两个城镇间都可以实现交通(不一定有直接的道路相连,只要互相间接通过道路可达即可)。问最少还需要建设多少条道路?
20
7
0 1
6 9
3 8
5 11
2 12
6 10
4 8
城镇道路统计表,下面是对数据的解释:
总共有20个城市,目前已经修改好了7条道路,问还需要修建多少条道路,才能让这20个城市之间全部相通?
解题思路
创建一个并查集UF _ Tree _ Weighted(20);
分别调用union(0, 1),union(6,9),union(3,8),union(5,11),union(2,12),union(6,10),union(4,8),表示已经修建好的道路把对应的城市连接起来;
如果城市全部连接起来,那么并查集中剩余的分组数目为1,所有的城市都在一个树中,所以,只需要获取当前并查集中剩余的数目,减去1,就是还需要修建的道路数目。
代码实现 import java.io.BufferedReader;import java.io.InputStreamReader;public class RoadUF { public static void main (String[] args) throws Exception { BufferedReader bufferedReader = new BufferedReader (new InputStreamReader (RoadUF.class.getClassLoader().getResourceAsStream("com/algorithm/_8_2Tree/UF/Test/Test.txt" ))); int totalNumber = Integer.parseInt(bufferedReader.readLine()); UFTree_Weighted uf = new UFTree_Weighted (totalNumber); int roadNumber = Integer.parseInt(bufferedReader.readLine()); for (int i = 0 ; i < roadNumber; i++) { String line = bufferedReader.readLine(); String[] str = line.split(" " ); int p = Integer.parseInt(str[0 ]); int q = Integer.parseInt(str[1 ]); uf.union(p, q); } int roads = uf.getCount() - 1 ; System.out.println("还需要修建" +roads+"条道路" ); } }
图 基本介绍 图是一种数据结构 ,其中结点可以具有零个或多个相邻元素。两个结点之间的连接称为边。结点也可以称为顶点。
概念
顶点、边、路径
无向图:顶点之间的连接没有方向
有向图:顶点之间的连接带有方向
带权图(网):边带权值
表示方式 图的表示方式有两种:二维数组表示(邻接矩阵 );链表表示(邻接表 )
邻接矩阵 邻接矩阵是表示图形中顶点之间相邻关系 的矩阵,对于n个顶点的图而言,矩阵是的row和col表示的是1…n个点。
邻接表 邻接矩阵需要为每个顶点都分配n个边的空间,其实有很多边都是不存在,会造成空间的一定损失 。
邻接表 的实现只关心存在的边,不关心不存在的边。因此没有空间浪费,邻接表由数组+链表组成
说明:
标号为0的节点的相关联的结点为1 2 3 4
标号为1的结点的相关联结点为0 4
标号为2的结点的相关联结点为0 4 5
……
案例
思路分析
存储顶点 String,使用ArrayList
保存矩阵int[] [] edges
代码实现 import java.util.ArrayList;import java.util.Arrays;public class Grap { private ArrayList<String> vertexList; private int [][] edges; private int numOfEdges; public static void main (String[] args) { int n = 5 ; String VertexValue[] = {"A" , "B" , "C" , "D" , "E" }; Grap grap = new Grap (n); for (String vertex : VertexValue) { grap.insertVertex(vertex); } grap.insertEdges(0 ,1 ,1 ); grap.insertEdges(0 ,2 ,1 ); grap.insertEdges(1 ,2 ,1 ); grap.insertEdges(1 ,3 ,1 ); grap.insertEdges(0 ,4 ,1 ); grap.show(); } public Grap (int n) { edges = new int [n][n]; vertexList = new ArrayList <String>(n); numOfEdges = 0 ; } public int getNumOfVertex () { return vertexList.size(); } public int getNumOfEdges () { return numOfEdges; } public String getValueByIndex (int i) { return vertexList.get(i); } public int getWeight (int v1, int v2) { return edges[v1][v2]; } public void show () { for (int [] link : edges) { System.out.println(Arrays.toString(link)); } } public void insertVertex (String vertex) { vertexList.add(vertex); } public void insertEdges (int v1, int v2, int weight) { edges[v1][v2] = weight; edges[v2][v1] = weight; numOfEdges++; } }
图的遍历 所谓图的遍历,即是对结点的访问。一个图有那么多个结点,如何遍历这些结点,需要特定策略,一般有两种访问策略:
深度优先遍历 思路分析 图的深度优先搜索(Depth First Search) 。
深度优先遍历,从初始访问结点出发,初始访问结点可能有多个邻接结点,深度优先遍历的策略就是首先访问第一个邻接结点,然后再以这个被访问的邻接结点作为初始结点,访问它的第一个邻接结点, 可以这样理解:每次都在访问完当前结点后首先访问当前结点的第一个邻接结点 。
我们可以看到,这样的访问策略是优先往纵向挖掘深入,而不是对一个结点的所有邻接结点进行横向访问。
显然,深度优先搜索是一个递归的过程
算法步骤
访问初始结点v,并标记结点v为已访问。
查找结点v的第一个邻接结点w。
若w存在,则继续执行4,如果w不存在,则回到第1步,将从v的下一个结点继续。
若w未被访问,对w进行深度优先遍历递归(即把w当做另一个v,然后进行步骤123)。
查找结点v的w邻接结点的下一个邻接结点,转到步骤3。
核心代码实现 public int getFirstNeighbor (int index) { for (int i = 0 ; i < vertexList.size(); i++) { if (edges[index][i] > 0 ) { return i; } } return -1 ; } public int getNextNeighbor (int v1, int v2) { for (int i = v2 + 1 ; i < vertexList.size(); i++) { if (edges[v1][i] > 0 ) { return i; } } return -1 ; } private void dfs (boolean [] isVisited, int i) { System.out.print(getValueByIndex(i) + "->" ); isVisited[i] = true ; int firstNeighbor = getFirstNeighbor(i); while (firstNeighbor != -1 ) { if (!isVisited[firstNeighbor]) { dfs(isVisited, firstNeighbor); } firstNeighbor = getNextNeighbor(i, firstNeighbor); } } public void dfs () { isVisited = new boolean [vertexList.size()]; for (int i = 0 ; i < getNumOfVertex(); i++) { if (!isVisited[i]) { dfs(isVisited, i); } } }
广度优先遍历 思路分析 图的广度优先搜索(Broad First Search) 。
类似于一个分层搜索 的过程,广度优先遍历需要使用一个队列以保持访问过的结点的顺序,以便按这个顺序来访问这些结点的邻接结点
算法步骤
访问初始结点v并标记结点v为已访问。
结点v入队列。
当队列非空时,继续执行,否则算法结束。
出队列,取得队头结点u。
查找结点u的第一个邻接结点w。
若结点u的邻接结点w不存在,则转到步骤3;否则循环执行以下三个步骤:
若结点w尚未被访问,则访问结点w并标记为已访问。
结点w入队列 。
查找结点u的继w邻接结点后的下一个邻接结点w,转到步骤6。
核心代码实现 public int getFirstNeighbor (int index) { for (int i = 0 ; i < vertexList.size(); i++) { if (edges[index][i] > 0 ) { return i; } } return -1 ; } public int getNextNeighbor (int v1, int v2) { for (int i = v2 + 1 ; i < vertexList.size(); i++) { if (edges[v1][i] > 0 ) { return i; } } return -1 ; } private void bfs (boolean [] isVisited, int i) { int u; int w; LinkedList queue = new LinkedList (); System.out.print(getValueByIndex(i) + "->" ); isVisited[i] = true ; queue.addLast(i); while (!queue.isEmpty()) { u = (Integer) queue.removeFirst(); w = getFirstNeighbor(u); while (w != -1 ) { if (!isVisited[w]) { System.out.print(getValueByIndex(w) + "->" ); isVisited[w] = true ; queue.addLast(w); } w = getNextNeighbor(u, w); } } } public void bfs () { isVisited = new boolean [vertexList.size()]; for (int i = 0 ; i < getNumOfVertex(); i++) { if (!isVisited[i]) { bfs(isVisited, i); } } }
代码汇总 深度优先 import java.util.ArrayList;import java.util.Arrays;public class DFSGrap { private ArrayList<String> vertexList; private int [][] edges; private int numOfEdges; private boolean [] isVisited; public DFSGrap (int n) { edges = new int [n][n]; vertexList = new ArrayList <String>(n); numOfEdges = 0 ; isVisited = new boolean [0 ]; } public int getNumOfVertex () { return vertexList.size(); } public int getNumOfEdges () { return numOfEdges; } public String getValueByIndex (int i) { return vertexList.get(i); } public int getWeight (int v1, int v2) { return edges[v1][v2]; } public void show () { for (int [] link : edges) { System.out.println(Arrays.toString(link)); } } public void insertVertex (String vertex) { vertexList.add(vertex); } public void insertEdges (int v1, int v2, int weight) { edges[v1][v2] = weight; edges[v2][v1] = weight; numOfEdges++; } public int getFirstNeighbor (int index) { for (int i = 0 ; i < vertexList.size(); i++) { if (edges[index][i] > 0 ) { return i; } } return -1 ; } public int getNextNeighbor (int v1, int v2) { for (int i = v2 + 1 ; i < vertexList.size(); i++) { if (edges[v1][i] > 0 ) { return i; } } return -1 ; } private void dfs (boolean [] isVisited, int i) { System.out.print(getValueByIndex(i) + "->" ); isVisited[i] = true ; int firstNeighbor = getFirstNeighbor(i); while (firstNeighbor != -1 ) { if (!isVisited[firstNeighbor]) { dfs(isVisited, firstNeighbor); } firstNeighbor = getNextNeighbor(i, firstNeighbor); } } public void dfs () { isVisited = new boolean [vertexList.size()]; for (int i = 0 ; i < getNumOfVertex(); i++) { if (!isVisited[i]) { dfs(isVisited, i); } } } } class DFSGrapDemo { public static void main (String[] args) { int n = 5 ; String VertexValue[] = {"A" , "B" , "C" , "D" , "E" }; DFSGrap grap = new DFSGrap (n); for (String vertex : VertexValue) { grap.insertVertex(vertex); } grap.insertEdges(0 , 1 , 1 ); grap.insertEdges(0 , 2 , 1 ); grap.insertEdges(1 , 2 , 1 ); grap.insertEdges(1 , 3 , 1 ); grap.insertEdges(1 , 4 , 1 ); grap.show(); System.out.println("深度遍历" ); grap.dfs(); } }
广度优先 import java.util.ArrayList;import java.util.Arrays;import java.util.LinkedList;public class BFSGrap { private ArrayList<String> vertexList; private int [][] edges; private int numOfEdges; private boolean [] isVisited; public BFSGrap (int n) { edges = new int [n][n]; vertexList = new ArrayList <String>(n); numOfEdges = 0 ; isVisited = new boolean [0 ]; } public int getNumOfVertex () { return vertexList.size(); } public int getNumOfEdges () { return numOfEdges; } public String getValueByIndex (int i) { return vertexList.get(i); } public int getWeight (int v1, int v2) { return edges[v1][v2]; } public void show () { for (int [] link : edges) { System.out.println(Arrays.toString(link)); } } public void insertVertex (String vertex) { vertexList.add(vertex); } public void insertEdges (int v1, int v2, int weight) { edges[v1][v2] = weight; edges[v2][v1] = weight; numOfEdges++; } public int getFirstNeighbor (int index) { for (int i = 0 ; i < vertexList.size(); i++) { if (edges[index][i] > 0 ) { return i; } } return -1 ; } public int getNextNeighbor (int v1, int v2) { for (int i = v2 + 1 ; i < vertexList.size(); i++) { if (edges[v1][i] > 0 ) { return i; } } return -1 ; } private void bfs (boolean [] isVisited, int i) { int u; int w; LinkedList queue = new LinkedList (); System.out.print(getValueByIndex(i) + "->" ); isVisited[i] = true ; queue.addLast(i); while (!queue.isEmpty()) { u = (Integer) queue.removeFirst(); w = getFirstNeighbor(u); while (w != -1 ) { if (!isVisited[w]) { System.out.print(getValueByIndex(w) + "->" ); isVisited[w] = true ; queue.addLast(w); } w = getNextNeighbor(u, w); } } } public void bfs () { isVisited = new boolean [vertexList.size()]; for (int i = 0 ; i < getNumOfVertex(); i++) { if (!isVisited[i]) { bfs(isVisited, i); } } } } class BFSGrapDemo { public static void main (String[] args) { int n = 5 ; String VertexValue[] = {"A" , "B" , "C" , "D" , "E" }; BFSGrap grap = new BFSGrap (n); for (String vertex : VertexValue) { grap.insertVertex(vertex); } grap.insertEdges(0 , 1 , 1 ); grap.insertEdges(0 , 2 , 1 ); grap.insertEdges(1 , 2 , 1 ); grap.insertEdges(1 , 3 , 1 ); grap.insertEdges(1 , 4 , 1 ); grap.show(); System.out.println("深度遍历" ); grap.bfs(); } }
深度优先和广度优先 实例
深度优先
广度优先
代码实现 public class Test { public static void main (String[] args) { int n = 8 ; String VertexValue[] = {"1" , "2" , "3" , "4" , "5" ,"6" ,"7" ,"8" }; BFSGrap bfsGrap = new BFSGrap (n); for (String vertex : VertexValue) { bfsGrap.insertVertex(vertex); } bfsGrap.insertEdges(0 , 1 , 1 ); bfsGrap.insertEdges(0 , 2 , 1 ); bfsGrap.insertEdges(1 , 3 , 1 ); bfsGrap.insertEdges(1 , 4 , 1 ); bfsGrap.insertEdges(3 , 7 , 1 ); bfsGrap.insertEdges(4 , 7 , 1 ); bfsGrap.insertEdges(2 , 5 , 1 ); bfsGrap.insertEdges(2 , 6 , 1 ); bfsGrap.insertEdges(5 , 6 , 1 ); System.out.println("广度优先:" ); bfsGrap.bfs(); System.out.println(); DFSGrap dfsGrap = new DFSGrap (n); for (String vertex : VertexValue) { dfsGrap.insertVertex(vertex); } dfsGrap.insertEdges(0 , 1 , 1 ); dfsGrap.insertEdges(0 , 2 , 1 ); dfsGrap.insertEdges(1 , 3 , 1 ); dfsGrap.insertEdges(1 , 4 , 1 ); dfsGrap.insertEdges(3 , 7 , 1 ); dfsGrap.insertEdges(4 , 7 , 1 ); dfsGrap.insertEdges(2 , 5 , 1 ); dfsGrap.insertEdges(2 , 6 , 1 ); dfsGrap.insertEdges(5 , 6 , 1 ); System.out.println("深度优先:" ); dfsGrap.dfs(); } }
常用算法 二分查找(非递归)
前面我们讲过了二分查找算法,是使用递归的方式,下面我们讲解二分查找算法的非递归方式;
二分查找法只适用于从有序的数列中进行查找(比如数字和字母等),将数列排序后再进行查找;
二分查找法的运行时间为对数时间O(log2 n) ,即查找到需要的目标位置最多只需要log2 n步,假设从[0,99]的队列(100个数,即n=100)中寻到目标数30,则需要查找步数为log2 100 , 即最多需要查找7次( 2^6 < 100 < 2^7)
实例 问题 数组 {1,3, 8, 10, 11, 67, 100}, 编程实现二分查找, 要求使用非递归的方式完成。
代码实现 public class _1BinarySearch { public static int binarySearch (int [] arr, int target) { int left = 0 ; int right = arr.length - 1 ; while (left <= right) { int mid = (left + right) / 2 ; if (arr[mid] == target) { return mid+1 ; } else if (arr[mid] > target) { right = mid - 1 ; } else { left = mid + 1 ; } } return -1 ; } public static int binarySearch (int [] arr, int left, int right, int findVal) { int mid = (left + right) / 2 ; int midVal = arr[mid]; if (left > right) { return -1 ; } if (findVal > midVal) { return binarySearch(arr, mid + 1 , right, findVal); } else if (findVal < midVal) { return binarySearch(arr, left, mid - 1 , findVal); } else { return mid; } } } class BinarySearchDemo { public static void main (String[] args) { int [] arr = {1 , 3 , 8 , 10 , 11 , 67 , 100 }; int i = _1BinarySearch.binarySearch(arr, 10 ); System.out.println(i); } }
分治算法 概述
分治法是一种很重要的算法。字面上的解释是“分而治之”,就是把一个复杂的问题分成两个或更多的相同或相似的子问题,再把子问题分成更小的子问题……直到最后子问题可以简单的直接求解,原问题的解即子问题的解的合并。这个技巧是很多高效算法的基础,如排序算法(快速排序,归并排序),傅立叶变换(快速傅立叶变换)……
分治算法可以求解的一些经典问题
二分搜索
大整数乘法
棋盘覆盖
合并排序
快速排序
线性时间选择
最接近点对问题
循环赛日程表
汉诺塔
步骤 分治法在每一层递归上都有三个步骤:
分解:将原问题分解为若干个规模较小,相互独立,与原问题形式相同的子问题; 解决:若子问题规模较小而容易被解决则直接解,否则递归地解各个子问题; 合并:将各个子问题的解合并为原问题的解。;
设计模式 分治(Divide-and-Conquer(P))算法设计模式如下:
其中|P|表示问题P的规模;
n0为一阈值,表示当问题P的规模不超过n0时,问题已容易直接解出,不必再继续分解。
ADHOC(P)是该分治法中的基本子算法,用于直接解小规模的问题P。
因此,当P的规模不超过n0时直接用算法ADHOC(P)求解。
算法MERGE(y1,y2,…,yk)是该分治法中的合并子算法,用于将P的子问题P1 ,P2 ,…,Pk的相应的解y1,y2,…,yk合并为P的解。
实例 问题 汉罗塔
大梵天创造世界的时候做了三根金刚石柱子,在一根柱子上从下往上按照大小顺序摞着64片黄金圆盘。大梵天命令婆罗门把圆盘从下面开始按大小顺序重新摆放在另一根柱子上。并且规定,在小圆盘上不能放大圆盘,在三根柱子之间一次只能移动一个圆盘。
思路分析
如果是有一个盘, A->C
如果我们有 n >= 2 情况,我们总是可以看做是两个盘:最下边的一个盘 、上面的所有盘
先把 最上面的盘 A->B
把最下边的盘 A->C
把B塔的所有盘 从 B->C
代码实现 public class _2Hanoitower { private static int i = 0 ; public static void main (String[] args) { hanoitower(6 , 'A' , 'B' , 'C' ); System.out.println("共" + i + "步" ); } public static void hanoitower (int num, char a, char b, char c) { while (true ) { if (num == 1 ) { i++; System.out.println("第1个盘子:" + a + "->" + c); } else { i++; hanoitower(num - 1 , a, c, b); System.out.println("第" + num + "个盘子:" + a + "->" + c); hanoitower(num - 1 , b, a, c); } return ; } } }
动态规划
动态规划(Dynamic Programming)算法的核心思想是:将大问题划分为小问题进行解决,从而一步步获取最优解的处理算法
动态规划算法与分治算法类似,其基本思想也是将待求解问题分解成若干个子问题,先求解子问题,然后从这些子问题的解得到原问题的解。
与分治法不同的是,适合于用动态规划求解的问题,经分解得到子问题往往不是互相独立的 。 ( 即下一个子阶段的求解是建立在上一个子阶段的解的基础上,进行进一步的求解 )
动态规划可以通过填表的方式来逐步推进,得到最优解.
实例 问题 背包问题:有一个背包,容量为4磅 , 现有如下物品
要求达到的目标为装入的背包的总价值最大,并且重量不超出
要求装入的物品不能重复
思路分析
背包问题主要是指一个给定容量的背包、若干具有一定价值和重量的物品,如何选择物品放入背包使物品的价值最大。其中又分01背包和完全背包(完全背包指的是:每种物品都有无限件可用)
这里的问题属于01背包,即每个物品最多放一个。而无限背包可以转化为01背包。
算法的主要思想,利用动态规划来解决。每次遍历到的第i个物品,根据w[i]和v[i]来确定是否需要将该物品放入背包中。即对于给定的n个物品,设v[i]、w[i]分别为第i个物品的价值和重量,C为背包的容量。再令v[i] [j]表示在前i个物品中能够装入容量为j的背包中的最大价值。则我们有下面的结果:
v[i][0]=v[0][j]=0; //表示填入表第一行和第一列是0

2. ```java
   当w[i]> j 时:v[i][j]=v[i-1][j]   // 当准备加入新增的商品的容量大于 当前背包的容量时,就直接使用上一个单元格的装入策略
```java
#### 代码实现

```java
//01背包
public class KnapsackProblem {

    public static void main(String[] args) {

        int[] weight = {1, 4, 3};//物品的重量
        int[] value = {1500, 3000, 2000};//物品的价值,这里的value[i]就是v[i]
        int m = 4;//背包的容量
        int n = value.length;//物品的个数

        //创建二维数组,表示背包
        //v[i][j] 表示在前i个物品中能装入容量为j的背包中的最大价值
        int[][] v = new int[n + 1][m + 1];

        //为了记录放入商品的情况,我们定一个二维数组
        int[][] path = new int[n + 1][m + 1];

        //初始化第一行和第一列,在本程序中可以不写,因为默认为0
        for (int i = 0; i < v.length; i++) {
            v[i][0] = 0;//将第一列设置为0
        }
        for (int i = 0; i < v[0].length; i++) {
            v[0][i] = 0;//将第一行设置为0
        }

        //根据前面得到的公式来动态规划处理
        for (int i = 1; i < v.length; i++) {//不处理第一行,i是从1开始的
            for (int j = 1; j < v[0].length; j++) {//不处理第一列,j是从1开始的
                //公式
                if (weight[i - 1] > j) {//当准备加入的商品的容量大于当前背包的容量时,因为我们程序i是从1开始的,因此原来公式中的w[i]修改为w[i-1]
                    v[i][j] = v[i - 1][j];//直接使用上一个单元格的装入策略
                } else {// 当准备加入的新增的商品的容量小于等于当前背包的容量。
                    //比较 上一个单元格能装入的最大价值 和 表示当前商品的价值+能加入的上一个商品最大数量的价值 的大小,那种情况价值大,取哪种情况。
                    //因为我们程序i是从1开始的,因此原来公式中的value[i]修改为value[i-1],weight[i]该我weight[i-1]

                    //v[i][j] = Math.max(v[i - 1][j], value[i - 1] + v[i ][j - weight[i]]);//Exception in thread "main" java.lang.ArrayIndexOutOfBoundsException: -3
                    //v[i][j] = Math.max(v[i - 1][j], value[i - 1] + v[i - 1][j - weight[i - 1]]);

                    //为了记录商品存放到背包的情况,我们不能兼得使用上面的工具
                    if (v[i - 1][j] < value[i - 1] + v[i - 1][j - weight[i - 1]]) {
                        v[i][j] = value[i - 1] + v[i - 1][j - weight[i - 1]];
                        //把当前的情况记录到path
                        path[i][j] = 1;
                    } else {
                        v[i][j] = v[i - 1][j];
                    }
                }
            }
        }

        //遍历v,查看一下当前情况
        for (int i = 0; i < v.length; i++) {
            for (int j = 0; j < v[i].length; j++) {
                System.out.print(v[i][j] + " ");
            }
            System.out.println();
        }

        //输出最后我们放入的商品
        //遍历path

        // 这样每更新一次最大值,对应情况的path就会被标记为1,而输出
        // 会输出会把所有放入情况都得到,而我们只需要最后的放入
//        for (int i = 0; i < path.length; i++) {
//            for (int j = 0; j < path[i].length; j++) {
//                if (path[i][j] == 1) {
//                    System.out.print("第" + i + "个商品放入到背包");
//                    j -= weight[i - 1];
//                }
//            }
//        }

        System.out.println("价值最大的情况:");
        int i = path.length - 1;//行的最大下标
        int j = path[0].length - 1;//列的最大下标
        while (i > 0 && j > 0) {//从path的最后开始找
            if (path[i][j] == 1) {
                System.out.println("第" + i + "个商品放入到背包");
                j -= weight[i - 1];//包的重量-当前商品的重量
            }
            i--;//已经找到一个商品,寻找下一个商品
        }

    }

}
KMP算法 暴力匹配算法实现 问题 字符串匹配问题:
有一个字符串 str1= “”硅硅谷 尚硅谷你尚硅 尚硅谷你尚硅谷你尚硅你好””,和一个子串 str2=”尚硅谷你尚硅你”
现在要判断 str1 是否含有 str2, 如果存在,就返回第一次出现的位置, 如果没有,则返回-1
思路分析 如果用暴力匹配的思路,并假设现在str1匹配到 i 位置,子串str2匹配到 j 位置,则有:
如果当前字符匹配成功(即str1[i] == str2[j]),则i++,j++,继续匹配下一个字符
如果失配(即str1[i]! = str2[j]),令i = i - (j - 1),j = 0。相当于每次匹配失败时,i 回溯,j 被置为0。
用暴力方法解决的话就会有大量的回溯,每次只移动一位,若是不匹配,移动到下一位接着判断,浪费了大量的时间。(不可行!)
暴力匹配算法实现.
代码实现 public class ViolenceMatch { public static void main (String[] args) { String str1 = "adsadasdasjkdbaskjdasj" ; String str2 = "ask" ; int i = violenceMatch(str1, str2); System.out.println(i); } public static int violenceMatch (String str1, String str2) { char [] s1 = str1.toCharArray(); char [] s2 = str2.toCharArray(); int len1 = s1.length; int len2 = s2.length; int i = 0 ; int j = 0 ; while (i < len1 && j < len2) { if (s1[i] == s2[j]) { i++; j++; } else { i = i - (j - 1 ); j = 0 ; } } if (j == len2) { return i - j; } else { return -1 ; } } }
KMP算法实现
KMP是一个解决模式串在文本串是否出现过,如果出现过,最早出现的位置的经典算法
Knuth-Morris-Pratt 字符串查找算法,简称为 “KMP算法”,常用于在一个文本串S内查找一个模式串P 的出现位置,这个算法由Donald Knuth、Vaughan Pratt、James H. Morris三人于1977年联合发表,故取这3人的姓氏命名此算法.
KMP方法算法就利用之前判断过信息,通过一个next数组,保存模式串中前后最长公共子序列的长度,每次回溯时,通过next数组找到,前面匹配过的位置,省去了大量的计算时间
问题
有一个字符串 str1= “BBC ABCDAB ABCDABCDABDE”,和一个子串 str2=”ABCDABD”
现在要判断 str1 是否含有 str2, 如果存在,就返回第一次出现的位置, 如果没有,则返回-1
思路分析 彻底理解KMP
“部分匹配值”就是”前缀”和”后缀”的最长的共有元素的长度。以”ABCDABD”为例,
-”A”的前缀和后缀都为空集,共有元素的长度为0;
-”AB”的前缀为[A],后缀为[B],共有元素的长度为0;
-”ABC”的前缀为[A, AB],后缀为[BC, C],共有元素的长度0;
-”ABCD”的前缀为[A, AB, ABC],后缀为[BCD, CD, D],共有元素的长度为0;
-”ABCDA”的前缀为[==A==, AB, ABC, ABCD],后缀为[BCDA, CDA, DA,==A==],共有元素为”A”,长度为1;
-”ABCDAB”的前缀为[A,==AB==, ABC, ABCD, ABCDA],后缀为[BCDAB, CDAB, DAB, ==AB==, B],共有元素为”AB”,长度为2;
-”ABCDABD”的前缀为[A, AB, ABC, ABCD, ABCDA, ABCDAB],后缀为[BCDABD, CDABD, DABD, ABD, BD, D],共有元素的长度为0。
当前缀和后缀中有相同的元素时,就可以把后缀中的元素当做是新的起点。
到达这个后缀的步长恰巧是:(已匹配的字符总长度 - 后缀的长度)
代码实现 public class KMPAlgorithm { public static void main (String[] args) { String str1 = "BBC ABCDAB ABCDABCDABDE" ; String str2 = "ABCDABD" ; int [] next = kmpNext(str2); System.out.println(Arrays.toString(next)); int index = kmpSearch(str1, str2, next); System.out.println(index); } public static int kmpSearch (String str1, String str2, int [] next) { for (int i = 0 , j = 0 ; i < str1.length(); i++) { while (j > 0 && str1.charAt(i) != str2.charAt(j)) { j = next[j - 1 ]; } if (str1.charAt(i) == str2.charAt(j)) { j++; } if (j == str2.length()) { return i - j + 1 ; } } return -1 ; } public static int [] kmpNext(String dest) { int [] next = new int [dest.length()]; next[0 ] = 0 ; for (int i = 1 , j = 0 ; i < dest.length(); i++) { while (j > 0 && dest.charAt(i) != dest.charAt(j)) { j = next[j - 1 ]; } if (dest.charAt(i) == dest.charAt(j)) { j++; } next[i] = j; } return next; } }
贪心算法
贪婪算法(贪心算法)是指在对问题进行求解时,在每一步选择中都采取最好或者最优(即最有利)的选择,从而希望能够导致结果是最好或者最优的算法(局部最优解 )
贪婪算法所得到的结果不一定是最优的结果 (有时候会是最优解),但是都是相对近似(接近)最优解的结果
实例 问题 集合覆盖问题
假设存在如下表的需要付费的广播台,以及广播台信号可以覆盖的地区。 如何选择最少的广播台,让所有的地区都可以接收到信号 。
广播台
覆盖地区
K1
“北京”, “上海”, “天津”
K2
“广州”, “北京”, “深圳”
K3
“成都”, “上海”, “杭州”
K4
“上海”, “天津”
K5
“杭州”, “大连”
思路分析 穷举法 如何找出覆盖所有地区的广播台的集合呢,使用穷举法实现,列出每个可能的广播台的集合,这被称为幂集。假设总的有n个广播台,则广播台的组合总共有2n -1 个,假设每秒可以计算10个子集, 如图:
广播台数量n
子集总数2n
需要的时间
5
32
3.2秒
10
1024
102.4秒
32
4294967296
13.6年
100
1.26*10030
4x10²³ 年
这种方法,效率低下
贪心算法 使用贪婪算法,效率高:
目前并没有算法可以快速计算得到准备的值, 使用贪婪算法,则可以得到非常接近的解,并且效率高。选择策略上,因为需要覆盖全部地区的最小集合:
遍历所有的广播电台, 找到一个覆盖了最多未覆盖的地区 的电台(此电台可能包含一些已覆盖的地区,但没有关系)
将这个电台加入到一个集合中(比如ArrayList), 想办法把该电台覆盖的地区在下次比较时去掉。
重复第1步直到覆盖了全部的地区。
代码实现 import java.util.*;public class GreedyAlgorithm { public static void main (String[] args) { GreedyAlgorithm ga = new GreedyAlgorithm (); Map<String, Set<String>> broadcasts = new HashMap <String, Set<String>>(); Set<String> set1 = new HashSet <String>(); set1.add("杭州" ); set1.add("北京" ); set1.add("上海" ); set1.add("天津" ); Set<String> set2 = new HashSet <String>(); set2.add("广州" ); set2.add("北京" ); set2.add("上海" ); set2.add("天津" ); Set<String> set3 = new HashSet <String>(); set3.add("成都" ); set3.add("武汉" ); set3.add("杭州" ); Set<String> set4 = new HashSet <String>(); set4.add("上海" ); set4.add("天津" ); Set<String> set5 = new HashSet <String>(); set5.add("广州" ); set5.add("杭州" ); set5.add("大连" ); broadcasts.put("K1" , set1); broadcasts.put("K2" , set2); broadcasts.put("K3" , set3); broadcasts.put("K4" , set4); broadcasts.put("K5" , set5); List<String> selects = ga.greedy(broadcasts); System.out.println(selects); } public List<String> greedy (Map<String, Set<String>> broadcasts) { Set<String> allAreas = new HashSet <String>(); for (Map.Entry<String, Set<String>> entry : broadcasts.entrySet()) { Set<String> area = entry.getValue(); Iterator<String> itArea = area.iterator(); while (itArea.hasNext()) { allAreas.add(itArea.next()); } } System.out.println(allAreas); List<String> selects = new ArrayList <String>(); Set<String> tempSet = new HashSet <String>(); String maxKey = null ; Set<String> tempMaxKeySet = new HashSet <String>(); while (!allAreas.isEmpty()) { maxKey = null ; tempMaxKeySet.clear(); for (String key : broadcasts.keySet()) { tempSet.clear(); Set<String> area = broadcasts.get(key); tempSet.addAll(area); tempSet.retainAll(allAreas); if (tempSet.size() > 0 && (maxKey == null || tempSet.size() > tempMaxKeySet.size())) { tempMaxKeySet.clear(); maxKey = key; Set<String> area2 = broadcasts.get(maxKey); tempMaxKeySet.addAll(area2); tempMaxKeySet.retainAll(allAreas); } } if (maxKey != null ) { selects.add(maxKey); allAreas.removeAll(broadcasts.get(maxKey)); } } return selects; } }
注意事项
贪婪算法所得到的结果不一定是最优的结果(有时候会是最优解),但是都是相对近似(接近)最优解的结果 比如上题的算法选出的是K1, K2, K3, K5,符合覆盖了全部的地区 。但是我们发现 K2, K3, K4, K5 也可以覆盖全部地区,如果K2 的使用成本低于K1,那么我们上题的 K1, K2, K3, K5 虽然是满足条件,但是并不是最优的。
普里姆算法
普利姆(Prim)算法求最小生成树,也就是在包含n个顶点的连通图中,找出只有(n-1)条边包含所有n个顶点的连通子图,也就是所谓的极小连通子图
普利姆的算法如下:
设G=(V,E)是连通网,T=(U,D)是最小生成树,V,U是顶点集合,E,D是边的集合
若从顶点u开始构造最小生成树,则从集合V中取出顶点u放入集合U中,标记顶点v的visited[u]=1
若集合U中顶点ui与集合V-U中的顶点vj之间存在边,则寻找这些边中权值最小的边,但不能构成回路,将顶点vj加入集合U中,将边(ui,vj)加入集合D中,标记visited[vj]=1
重复步骤②,直到U与V相等,即所有顶点都被标记为访问过,此时D中有n-1条边
提示: 单独看步骤很难理解,我们通过代码来讲解,比较好理解.
问题
有胜利乡有7个村庄(A, B, C, D, E, F, G) ,现在需要修路把7个村庄连通
各个村庄的距离用边线表示(权) ,比如 A – B 距离 5公里
问:如何修路保证各个村庄都能连通,并且总的修建公路总里程最短?
思路: 将10条边,连接即可,但是总的里程数不是最小;
正确的思路:就是尽可能的选择少的路线,并且每条路线最小,保证总里程数最少。
思路分析 最小生成树 修路问题本质就是就是最小生成树问题, 先介绍一下最小生成树(Minimum Cost Spanning Tree),简称MST。
给定一个带权的无向连通图,如何选取一棵生成树,使树上所有边上权的总和为最小,这叫最小生成树;
N个顶点,一定有N-1条边;
包含全部顶点;
N-1条边都在图中;
举例说明,如图:
求最小生成树的算法主要是普里姆算法 和克鲁斯卡尔算法
图解
从 < A > 顶点开始处理 =》 < A , G > 2
< A , G > 开始,将A 和 G 顶点和他们相邻的还没有访问的顶点进行处理 =》< A , G , B >
A-C[7]、A-B[5]、G-B[3]、G-E[4]、G-F[6]
< A , G , B > 开始,将 A , G , B 顶点和他们相邻的还没有访问的顶点进行处理=》 < A , G , B , E >
A-C[7]、G-E[4]、G-F[6]、B-D[9]
完整步骤
{A}->G //第一 次大循环,对应边<A,G> 权值:2
{A, G}->B //第2次大循环,确定{A,G}中的节点和没有走过的节点哪个时最近的,对应边<G, B>权值:3
{A, G, B}->E//第3次大循环,对应,边<G, E>权值:4
{A, G, B, E}->F//第4次大循环,对应边<E,F>权值:5
{A, G, B, E, F}->D//第5次大循环,对应边<F,D>权值:4
{A, G, B, E, F, D}->C//第6次大循环,对应 边<A,C>权值:7
{A, G, B, E, F, D, C}
代码实现 import java.util.Arrays;public class PrimAlogrithm { public static void main (String[] args) { char [] data = new char []{'A' , 'B' , 'C' , 'D' , 'E' , 'F' , 'G' }; int verxs = data.length; int [][] weight = new int [][]{ {10000 , 5 , 7 , 10000 , 10000 , 10000 , 2 }, {5 , 10000 , 10000 , 9 , 10000 , 10000 , 3 }, {7 , 10000 , 10000 , 10000 , 8 , 10000 , 10000 }, {10000 , 9 , 10000 , 10000 , 10000 , 4 , 10000 }, {10000 , 10000 , 8 , 10000 , 10000 , 5 , 4 }, {10000 , 10000 , 10000 , 4 , 5 , 10000 , 6 }, {2 , 3 , 10000 , 10000 , 4 , 6 , 10000 },}; MGraph graph = new MGraph (verxs); MinTree minTree = new MinTree (); minTree.createGraph(graph, verxs, data, weight); minTree.show(graph); minTree.prim(graph, 0 ); } } class MinTree { public void createGraph (MGraph graph, int verxs, char data[], int [][] weight) { for (int i = 0 ; i < verxs; i++) { graph.data[i] = data[i]; for (int j = 0 ; j < verxs; j++) { graph.weight[i][j] = weight[i][j]; } } } public void show (MGraph graph) { for (int [] link : graph.weight) { System.out.println(Arrays.toString(link)); } } public void prim (MGraph graph, int v) { int visited[] = new int [graph.verxs]; for (int i = 0 ; i < graph.verxs; i++) { visited[i] = 0 ; } visited[v] = 1 ; int h1 = -1 ; int h2 = -1 ; int minWeight = 10000 ; for (int k = 1 ; k < graph.verxs; k++) { for (int i = 0 ; i < graph.verxs; i++) { for (int j = 0 ; j < graph.verxs; j++) { if (visited[i] == 1 && visited[j] == 0 && graph.weight[i][j] < minWeight) { minWeight = graph.weight[i][j]; h1 = i; h2 = j; } } } System.out.println("边<" + graph.data[h1] + "," + graph.data[h2] + ">权值:" + minWeight); visited[h2] = 1 ; minWeight = 10000 ; } } } class MGraph { int verxs; char [] data; int [][] weight; public MGraph (int verxs) { this .verxs = verxs; data = new char [verxs]; weight = new int [verxs][verxs]; } }
克鲁斯卡尔算法
克鲁斯卡尔(Kruskal)算法,是用来求加权连通图的最小生成树的算法。
基本思想 :按照权值从小到大的顺序选择n-1条边,并保证这n-1条边不构成回路具体做法 :首先构造一个只含n个顶点的森林,然后依权值从小到大从连通网中选择边加入到森林中,并使森林中不产生回路,直至森林变成一棵树为止。
问题
某城市新增7个站点(A, B, C, D, E, F, G) ,现在需要修路把7个站点连通;
各个站点的距离用边线表示(权) ,比如 A – B 距离 12公里;
问:如何修路保证各个站点都能连通,并且总的修建公路总里程最短?
思路分析 在含有n个顶点的连通图中选择n-1条边,构成一棵极小连通子图,并使该连通子图中n-1条边上权值之和达到最小,则称其为连通网的最小生成树。
例如,对于如上图G4所示的连通网可以有多棵权值总和不相同的生成树。
图解
文字描述
将边<E,F>加入R中。
边<E,F>的权值最小,因此将它加入到最小生成树结果R中。
将边<C,D>加入R中。
上一步操作之后,边<C,D>的权值最小,因此将它加入到最小生成树结果R中。
将边<D,E>加入R中。
上一步操作之后,边<D,E>的权值最小,因此将它加入到最小生成树结果R中。
将边<B,F>加入R中。
上一步操作之后,边<C,E>的权值最小,但<C,E>会和已有的边构成回路;因此,跳过边<C,E>。同理,跳过边<C,F>。将边<B,F>加入到最小生成树结果R中。
将边<E,G>加入R中。
上一步操作之后,边<E,G>的权值最小,因此将它加入到最小生成树结果R中。
将边<A,B>加入R中。
上一步操作之后,边<F,G>的权值最小,但<F,G>会和已有的边构成回路;因此,跳过边<F,G>。同理,跳过边<B,C>。将边<A,B>加入到最小生成树结果R中。
**此时,最小生成树构造完成!它包括的边依次是:<E,F> <C,D> <D,E> <B,F> <E,G> <A,B>**。
算法分析 根据前面介绍的克鲁斯卡尔算法的基本思想和做法,我们能够了解到,克鲁斯卡尔算法重点需要解决的以下两个问题:
重合判断思路
在将<E,F> <C,D> <D,E>加入到最小生成树R中之后,这几条边的顶点就都有了终点:
C的终点是F。
D的终点是F。
E的终点是F。
F的终点是F。
关于终点的说明:
就是将所有顶点按照从小到大的顺序排列好之后;某个顶点的终点就是”与它连通的最大顶点”。
因此,接下来,虽然<C,E>是权值最小的边。但是C和E的终点都是F,即它们的终点相同,因此,将<C,E>加入最小生成树的话,会形成回路。这就是判断回路的方式。也就是说,==我们加入的边的两个顶点不能都指向同一个终点,否则将构成回路。==【后面有代码说明】
代码实现 import java.util.Arrays;public class KruskalAlgorithm { private int edgeNum; private char [] verstexs; private int [][] matrix; private static final int INF = Integer.MAX_VALUE; public static void main (String[] args) { char [] vertexs = {'A' , 'B' , 'C' , 'D' , 'E' , 'F' , 'G' }; int matrix[][] = { {0 , 12 , INF, INF, INF, 16 , 14 }, {12 , 0 , 10 , INF, INF, 7 , INF}, {INF, 10 , 0 , 3 , 5 , 6 , INF}, {INF, INF, 3 , 0 , 4 , INF, INF}, {INF, INF, 5 , 4 , 0 , 2 , 8 }, {16 , 7 , 6 , INF, 2 , 0 , 9 }, {14 , INF, INF, INF, 8 , 9 , 0 }}; KruskalAlgorithm kruskalAlgorithm = new KruskalAlgorithm (vertexs, matrix); kruskalAlgorithm.show(); System.out.println("排序前:" ); for (int i = 0 ; i < kruskalAlgorithm.getEdges().length; i++) { System.out.println(kruskalAlgorithm.getEdges()[i]); } System.out.println("排序后:" ); for (int i = 0 ; i < kruskalAlgorithm.getEdges().length; i++) { System.out.println(kruskalAlgorithm.sortEdges(kruskalAlgorithm.getEdges())[i]); } kruskalAlgorithm.kruskal(); } public KruskalAlgorithm (char [] verstexs, int [][] matrix) { int vlen = verstexs.length; this .verstexs = new char [vlen]; for (int i = 0 ; i < verstexs.length; i++) { this .verstexs[i] = verstexs[i]; } this .matrix = new int [vlen][vlen]; for (int i = 0 ; i < vlen; i++) { for (int j = 0 ; j < vlen; j++) { this .matrix[i][j] = matrix[i][j]; } } for (int i = 0 ; i < vlen; i++) { for (int j = i + 1 ; j < vlen; j++) { if (this .matrix[i][j] != INF) { edgeNum++; } } } } public void show () { System.out.println("邻接矩阵为:" ); for (int i = 0 ; i < verstexs.length; i++) { for (int j = 0 ; j < verstexs.length; j++) { System.out.printf("%-12d" , matrix[i][j]); } System.out.println(); } } private EData[] sortEdges(EData[] edges) { for (int i = 0 ; i < edges.length - 1 ; i++) { for (int j = 0 ; j < edges.length - 1 - i; j++) { if (edges[j].weight > edges[j + 1 ].weight) { EData tmp = edges[j]; edges[j] = edges[j + 1 ]; edges[j + 1 ] = tmp; } } } return edges; } private int getPosition (char ch) { for (int i = 0 ; i < verstexs.length; i++) { if (verstexs[i] == ch) { return i; } } return -1 ; } private EData[] getEdges() { int index = 0 ; EData[] edges = new EData [edgeNum]; for (int i = 0 ; i < verstexs.length; i++) { for (int j = i + 1 ; j < verstexs.length; j++) { if (matrix[i][j] != INF) { edges[index++] = new EData (verstexs[i], verstexs[j], matrix[i][j]); } } } return edges; } private int getEnd (int [] ends, int i) { while (ends[i] != 0 ) { i = ends[i]; } return i; } public void kruskal () { int index = 0 ; int [] ends = new int [edgeNum]; EData[] rets = new EData [edgeNum]; EData[] edges = getEdges(); System.out.println("图的边的集合如下,共" + edges.length + "条" ); for (int i = 0 ; i < edges.length; i++) { System.out.println(edges[i]); } sortEdges(edges); for (int i = 0 ; i < edgeNum; i++) { int p1 = getPosition(edges[i].start); int p2 = getPosition(edges[i].end); int m = getEnd(ends, p1); int n = getEnd(ends, p2); if (m != n) { ends[m] = n; rets[index++] = edges[i]; } System.out.println("ends:" + Arrays.toString(ends)); } System.out.println("最小生成树为:" ); for (int i = 0 ; i < index; i++) { System.out.println(rets[i]); } } } class EData { char start; char end; int weight; public EData (char start, char end, int weight) { this .start = start; this .end = end; this .weight = weight; } public String toString () { return "EDATA [<" + start + "," + end + ">=" + weight + "]" ; } }
运行结果 邻接矩阵为: 0 12 2147483647 2147483647 2147483647 16 14 12 0 10 2147483647 2147483647 7 2147483647 2147483647 10 0 3 5 6 2147483647 2147483647 2147483647 3 0 4 2147483647 2147483647 2147483647 2147483647 5 4 0 2 8 16 7 6 2147483647 2 0 9 14 2147483647 2147483647 2147483647 8 9 0 排序前: EDATA [<A,B>=12 ] EDATA [<A,F>=16 ] EDATA [<A,G>=14 ] EDATA [<B,C>=10 ] EDATA [<B,F>=7 ] EDATA [<C,D>=3 ] EDATA [<C,E>=5 ] EDATA [<C,F>=6 ] EDATA [<D,E>=4 ] EDATA [<E,F>=2 ] EDATA [<E,G>=8 ] EDATA [<F,G>=9 ] 排序后: EDATA [<E,F>=2 ] EDATA [<C,D>=3 ] EDATA [<D,E>=4 ] EDATA [<C,E>=5 ] EDATA [<C,F>=6 ] EDATA [<B,F>=7 ] EDATA [<E,G>=8 ] EDATA [<F,G>=9 ] EDATA [<B,C>=10 ] EDATA [<A,B>=12 ] EDATA [<A,G>=14 ] EDATA [<A,F>=16 ] 图的边的集合如下,共12 条 EDATA [<A,B>=12 ] EDATA [<A,F>=16 ] EDATA [<A,G>=14 ] EDATA [<B,C>=10 ] EDATA [<B,F>=7 ] EDATA [<C,D>=3 ] EDATA [<C,E>=5 ] EDATA [<C,F>=6 ] EDATA [<D,E>=4 ] EDATA [<E,F>=2 ] EDATA [<E,G>=8 ] EDATA [<F,G>=9 ] ends: ends:[0 , 0 , 0 , 0 , 5 , 0 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 0 , 3 , 0 , 5 , 0 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 0 , 3 , 5 , 5 , 0 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 0 , 3 , 5 , 5 , 0 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 0 , 3 , 5 , 5 , 0 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 5 , 3 , 5 , 5 , 0 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 5 , 3 , 5 , 5 , 6 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 5 , 3 , 5 , 5 , 6 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[0 , 5 , 3 , 5 , 5 , 6 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[6 , 5 , 3 , 5 , 5 , 6 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[6 , 5 , 3 , 5 , 5 , 6 , 0 , 0 , 0 , 0 , 0 , 0 ] ends:[6 , 5 , 3 , 5 , 5 , 6 , 0 , 0 , 0 , 0 , 0 , 0 ] 最小生成树为: EDATA [<E,F>=2 ] EDATA [<C,D>=3 ] EDATA [<D,E>=4 ] EDATA [<B,F>=7 ] EDATA [<E,G>=8 ] EDATA [<A,B>=12 ]
迪杰斯特拉算法 迪杰斯特拉(Dijkstra)算法是典型最短路径算法 ,用于计算一个结点到其他结点的最短路径。 它的主要特点是以起始点为中心向外层层扩展**(广度优先搜索思想**),直到扩展到终点为止。
算法过程 设置出发顶点为v,顶点集合V{v1,v2,vi …},v到V中各顶点的距离构成距离集合Dis,Dis{d1,d2,di …},Dis集合记录着v到图中各顶点的距离(到自身可以看作0,v到vi 距离对应为di )
从Dis中选择值最小的di并移出Dis集合,同时移出V集合中对应的顶点vi。此时被移出的部分,v到vi即为最短路径。
更新Dis集合,更新规则为:比较v到V集合中顶点的距离值,与v通过vi到V集合中顶点的距离值,保留值较小的一个(同时也应该更新顶点的前驱节点为vi,表明是通过vi到达的)。
重复执行两步骤,直到最短路径顶点为目标顶点即可结束。
问题
战争时期,胜利乡有7个村庄(A, B, C, D, E, F, G) ,现在有六个邮差,从G点出发,需要分别把邮件分别送到 A, B, C , D, E, F 六个村庄
各个村庄的距离用边线表示(权) ,比如 A – B 距离是5公里
问:如何计算出G村庄到其它各个村庄的最短距离?
如果从其它点出发到各个点的最短距离又是多少?
思路分析
代码实现 完整代码 public class DijkstraAlgorithm { public static void main (String[] args) { char [] vertexs = {'A' , 'B' , 'C' , 'D' , 'E' , 'F' , 'G' }; int [][] martex = new int [vertexs.length][vertexs.length]; final int N = 65535 ; martex[0 ] = new int []{N, 5 , 7 , N, N, N, 2 }; martex[1 ] = new int []{5 , N, N, 9 , N, N, 3 }; martex[2 ] = new int []{7 , N, N, N, 8 , N, N}; martex[3 ] = new int []{N, 9 , N, N, N, 4 , N}; martex[4 ] = new int []{N, N, 8 , N, N, 5 , 4 }; martex[5 ] = new int []{N, N, N, 4 , 5 , N, 6 }; martex[6 ] = new int []{2 , 3 , N, N, 4 , 6 , N}; Graph graph = new Graph (vertexs, martex); graph.show(); graph.dijkstra(6 ); graph.showDijkstra(); } } class VisitedVertex { public int [] already_arr; public int [] pre_visited; public int [] dis; public VisitedVertex (int length, int index) { this .already_arr = new int [length]; this .pre_visited = new int [length]; this .dis = new int [length]; Arrays.fill(dis, 65535 ); this .already_arr[index] = 1 ; this .dis[index] = 0 ; } public boolean in (int index) { return already_arr[index] == 1 ; } public void updateDis (int index, int len) { dis[index] = len; } public void updatePre (int pre, int index) { pre_visited[pre] = index; } public int getDis (int index) { return dis[index]; } public int updateArr () { int min = 65535 , index = 0 ; for (int i = 0 ; i < already_arr.length; i++) { if (already_arr[i] == 0 && dis[i] < min) { min = dis[i]; index = i; } } already_arr[index] = 1 ; return index; } public void show () { System.out.println("already_arr:" ); for (int i : already_arr) { System.out.print(i + " " ); } System.out.println(); System.out.println("pre_visited:" ); for (int i : pre_visited) { System.out.print(i + " " ); } System.out.println(); System.out.println("dis:" ); for (int i : dis) { System.out.print(i + " " ); } System.out.println(); char [] vertexs = {'A' , 'B' , 'C' , 'D' , 'E' , 'F' , 'G' }; int count = 0 ; for (int i : dis) { if (i != 65535 ) { System.out.print(vertexs[count] + "(" + i + ")" + " " ); } else { System.out.println("N" ); } } } } class Graph { private char [] vertex; private int [][] matrix; private VisitedVertex visitedVertex; public Graph (char [] vertex, int [][] matrix) { this .vertex = vertex; this .matrix = matrix; } public void show () { for (int [] link : matrix) { System.out.println(Arrays.toString(link)); } } public void dijkstra (int index) { visitedVertex = new VisitedVertex (vertex.length, index); update(index); for (int i = 1 ; i < vertex.length; i++) { index = visitedVertex.updateArr(); update(index); } } private void update (int index) { int len = 0 ; for (int i = 0 ; i < matrix[index].length; i++) { len = visitedVertex.getDis(index) + matrix[index][i]; if (!visitedVertex.in(i) && len < visitedVertex.getDis(i)) { visitedVertex.updatePre(i, index); visitedVertex.updateDis(i, len); } } } public void showDijkstra () { visitedVertex.show(); } }
运行结果:
[65535 , 5 , 7 , 65535 , 65535 , 65535 , 2 ] [5 , 65535 , 65535 , 9 , 65535 , 65535 , 3 ] [7 , 65535 , 65535 , 65535 , 8 , 65535 , 65535 ] [65535 , 9 , 65535 , 65535 , 65535 , 4 , 65535 ] [65535 , 65535 , 8 , 65535 , 65535 , 5 , 4 ] [65535 , 65535 , 65535 , 4 , 5 , 65535 , 6 ] [2 , 3 , 65535 , 65535 , 4 , 6 , 65535 ] already_arr: 1 1 1 1 1 1 1 pre_visited: 6 6 0 5 6 6 0 dis: 2 3 9 10 4 6 0 A(2 ) A(3 ) A(9 ) A(10 ) A(4 ) A(6 ) A(0 )
部分代码解释 private void update (int index) { int len = 0 ; for (int i = 0 ; i < matrix[index].length; i++) { len = visitedVertex.getDis(index) + matrix[index][i]; if (!visitedVertex.in(i) && len < visitedVertex.getDis(i)) { visitedVertex.updatePre(i, index); visitedVertex.updateDis(i, len); } } }
修改前:
修改后:
佛洛伊德算法 概述
和Dijkstra算法一样,弗洛伊德(Floyd)算法也是一种用于寻找给定的加权图中顶点间最短路径的算法。该算法名称以创始人之一、1978年图灵奖获得者、斯坦福大学计算机科学系教授罗伯特·弗洛伊德命名
弗洛伊德算法(Floyd)计算图中各个顶点之间的最短路径
迪杰斯特拉算法用于计算图中某一个顶点到其他顶点的最短路径。
弗洛伊德算法 VS 迪杰斯特拉算法 :迪杰斯特拉算法通过选定的被访问顶点 ,求出从出发访问顶点到其他顶点的最短路径 ;弗洛伊德算法中每一个顶点都是出发访问点 ,所以需要将每一个顶点看做被访问顶点,求出从每一个顶点到其他顶点的最短路径 。
问题
胜利乡有7个村庄(A, B, C, D, E, F, G)
各个村庄的距离用边线表示(权) ,比如 A – B 距离 5公里
问:如何计算出各村庄到 其它各村庄的最短距离?
算法分析
设置顶点vi到顶点vk的最短路径已知为Lik,顶点vk到vj的最短路径已知为Lkj,顶点vi到vj的路径为Lij,则vi到vj的最短路径为:min((Lik+Lkj),Lij),vk的取值为图中所有顶点,则可获得vi到vj的最短路径
至于vi到vk的最短路径Lik或者vk到vj的最短路径Lkj,是以同样的方式获得
弗洛伊德(Floyd)算法图解分析-举例说明
佛洛依德算法的步骤:
第一轮循环中,以A(下标为:0)作为中间顶点,距离表和前驱关系更新为:
分析如下:
以A顶点作为中间顶点是,B->A->C的距离由N->9,同理C到B;C->A->G的距离由N->12,同理G到C
更换中间顶点,循环执行操作,直到所有顶点都作为中间顶点更新后,计算结束
A A A F G G A
B B A B G G B
C A C F C E A
G D E D F D F
G G E F E E E
G G E F F F F
G G A F G G G
代码实现 import java.util.Arrays;public class FloydAlgorithm { public static void main (String[] args) { char [] vertex = {'A' , 'B' , 'C' , 'D' , 'E' , 'F' , 'G' }; int [][] matrix = new int [vertex.length][vertex.length]; final int N = 65535 ; matrix[0 ] = new int []{0 , 5 , 7 , N, N, N, 2 }; matrix[1 ] = new int []{5 , 0 , N, 9 , N, N, 3 }; matrix[2 ] = new int []{7 , N, 0 , N, 8 , N, N}; matrix[3 ] = new int []{N, 9 , N, 0 , N, 4 , N}; matrix[4 ] = new int []{N, N, 8 , N, 0 , 5 , 4 }; matrix[5 ] = new int []{N, N, N, 4 , 5 , 0 , 6 }; matrix[6 ] = new int []{2 , 3 , N, N, 4 , 6 , 0 }; Graph graph = new Graph (7 , matrix, vertex); System.out.println("佛洛依德算法执行前:" ); graph.show(); graph.floyd(); System.out.println("佛洛依德算法执行后:" ); graph.show(); } } class Graph { private char [] vertex; private int [][] dis; private int [][] pre; final int N = 65535 ; public Graph (int length, int [][] matrix, char [] vertex) { this .vertex = vertex; this .dis = matrix; this .pre = new int [length][length]; for (int i = 0 ; i < pre.length; i++) { Arrays.fill(pre[i], i); } } public void show () { for (int i = 0 ; i < dis.length; i++) { for (int j = 0 ; j < pre.length; j++) { System.out.print(vertex[pre[i][j]] + " " ); } System.out.println(); for (int j = 0 ; j < dis.length; j++) { System.out.print("(" + vertex[i] + "—>" + vertex[j] + ",min:" + dis[i][j] + ") " ); } System.out.println(); System.out.println(); } } public void floyd () { int len = 0 ; for (int k = 0 ; k < dis.length; k++) { for (int i = 0 ; i < dis.length; i++) { for (int j = 0 ; j < dis.length; j++) { if (k != i && k != j && dis[i][k] != N && dis[k][j] != N) { len = dis[i][k] + dis[k][j]; if (len < dis[i][j]) { dis[i][j] = len; pre[i][j] = pre[k][j]; } } } } } } }
佛洛依德算法执行前: A A A A A A A (A—>A,min:0 ) (A—>B,min:5 ) (A—>C,min:7 ) (A—>D,min:65535 ) (A—>E,min:65535 ) (A—>F,min:65535 ) (A—>G,min:2 ) B B B B B B B (B—>A,min:5 ) (B—>B,min:0 ) (B—>C,min:65535 ) (B—>D,min:9 ) (B—>E,min:65535 ) (B—>F,min:65535 ) (B—>G,min:3 ) C C C C C C C (C—>A,min:7 ) (C—>B,min:65535 ) (C—>C,min:0 ) (C—>D,min:65535 ) (C—>E,min:8 ) (C—>F,min:65535 ) (C—>G,min:65535 ) D D D D D D D (D—>A,min:65535 ) (D—>B,min:9 ) (D—>C,min:65535 ) (D—>D,min:0 ) (D—>E,min:65535 ) (D—>F,min:4 ) (D—>G,min:65535 ) E E E E E E E (E—>A,min:65535 ) (E—>B,min:65535 ) (E—>C,min:8 ) (E—>D,min:65535 ) (E—>E,min:0 ) (E—>F,min:5 ) (E—>G,min:4 ) F F F F F F F (F—>A,min:65535 ) (F—>B,min:65535 ) (F—>C,min:65535 ) (F—>D,min:4 ) (F—>E,min:5 ) (F—>F,min:0 ) (F—>G,min:6 ) G G G G G G G (G—>A,min:2 ) (G—>B,min:3 ) (G—>C,min:65535 ) (G—>D,min:65535 ) (G—>E,min:4 ) (G—>F,min:6 ) (G—>G,min:0 ) 佛洛依德算法执行后: A A A F G G A (A—>A,min:0 ) (A—>B,min:5 ) (A—>C,min:7 ) (A—>D,min:12 ) (A—>E,min:6 ) (A—>F,min:8 ) (A—>G,min:2 ) B B A B G G B (B—>A,min:5 ) (B—>B,min:0 ) (B—>C,min:12 ) (B—>D,min:9 ) (B—>E,min:7 ) (B—>F,min:9 ) (B—>G,min:3 ) C A C F C E A (C—>A,min:7 ) (C—>B,min:12 ) (C—>C,min:0 ) (C—>D,min:17 ) (C—>E,min:8 ) (C—>F,min:13 ) (C—>G,min:9 ) G D E D F D F (D—>A,min:12 ) (D—>B,min:9 ) (D—>C,min:17 ) (D—>D,min:0 ) (D—>E,min:9 ) (D—>F,min:4 ) (D—>G,min:10 ) G G E F E E E (E—>A,min:6 ) (E—>B,min:7 ) (E—>C,min:8 ) (E—>D,min:9 ) (E—>E,min:0 ) (E—>F,min:5 ) (E—>G,min:4 ) G G E F F F F (F—>A,min:8 ) (F—>B,min:9 ) (F—>C,min:13 ) (F—>D,min:4 ) (F—>E,min:5 ) (F—>F,min:0 ) (F—>G,min:6 ) G G A F G G G (G—>A,min:2 ) (G—>B,min:3 ) (G—>C,min:9 ) (G—>D,min:10 ) (G—>E,min:4 ) (G—>F,min:6 ) (G—>G,min:0 )